وبلاگ
یاد بگیرید، بهتر جواب بدهید
راهنماهای کاربردی برای کسبوکارهایی که میخواهند سریعتر، دقیقتر و شبانهروز به مشتری جواب بدهند.


آیا مدل شما روی Trainium اجرا میشود؟ این ابزار جواب میدهد
هاگینگفیس ابزاری ساخته که نشان میدهد یک مدل ترنسفورمرز بدون تغییر روی AWS Trainium اجرا میشود یا نه، همراه با اسکریپت اجرا و نتایج تست.
ادامهٔ مطلب
لیتپیوت؛ وقتی مقاله تازه مسیر ایده پژوهشی را عوض میکند
لیتپیوت ایده پژوهشی را به مسئله، مشارکت و ارزیابی میشکند و هر بخش را با مقالات علمی میسنجد؛ در مطالعهای با ۱۷ پژوهشگر، ایدهها مستندتر ارزیابی شدند.
ادامهٔ مطلب
نقشه جنگلهای جهان با دقت ۱۰ متر؛ چه چیزی جای جنگل را میگیرد؟
گوگل دیپمایند نقشهای با دقت ۱۰ متر منتشر کرده که شش نوع جنگل و کاربری زمین را از هم جدا میکند و نشان میدهد جای جنگل طبیعی چه چیزی آمده است.
ادامهٔ مطلب
Granite Timeseries Ensemble؛ ترکیب چهار مدل برای پیشبینی دقیقتر
IBM با Granite Timeseries Ensemble چهار مدل پیشبینی سری زمانی را بدون آموزش مجدد ترکیب میکند؛ یک پیشفرض آماده با پیشبینی نقطهای و چندکی.
ادامهٔ مطلب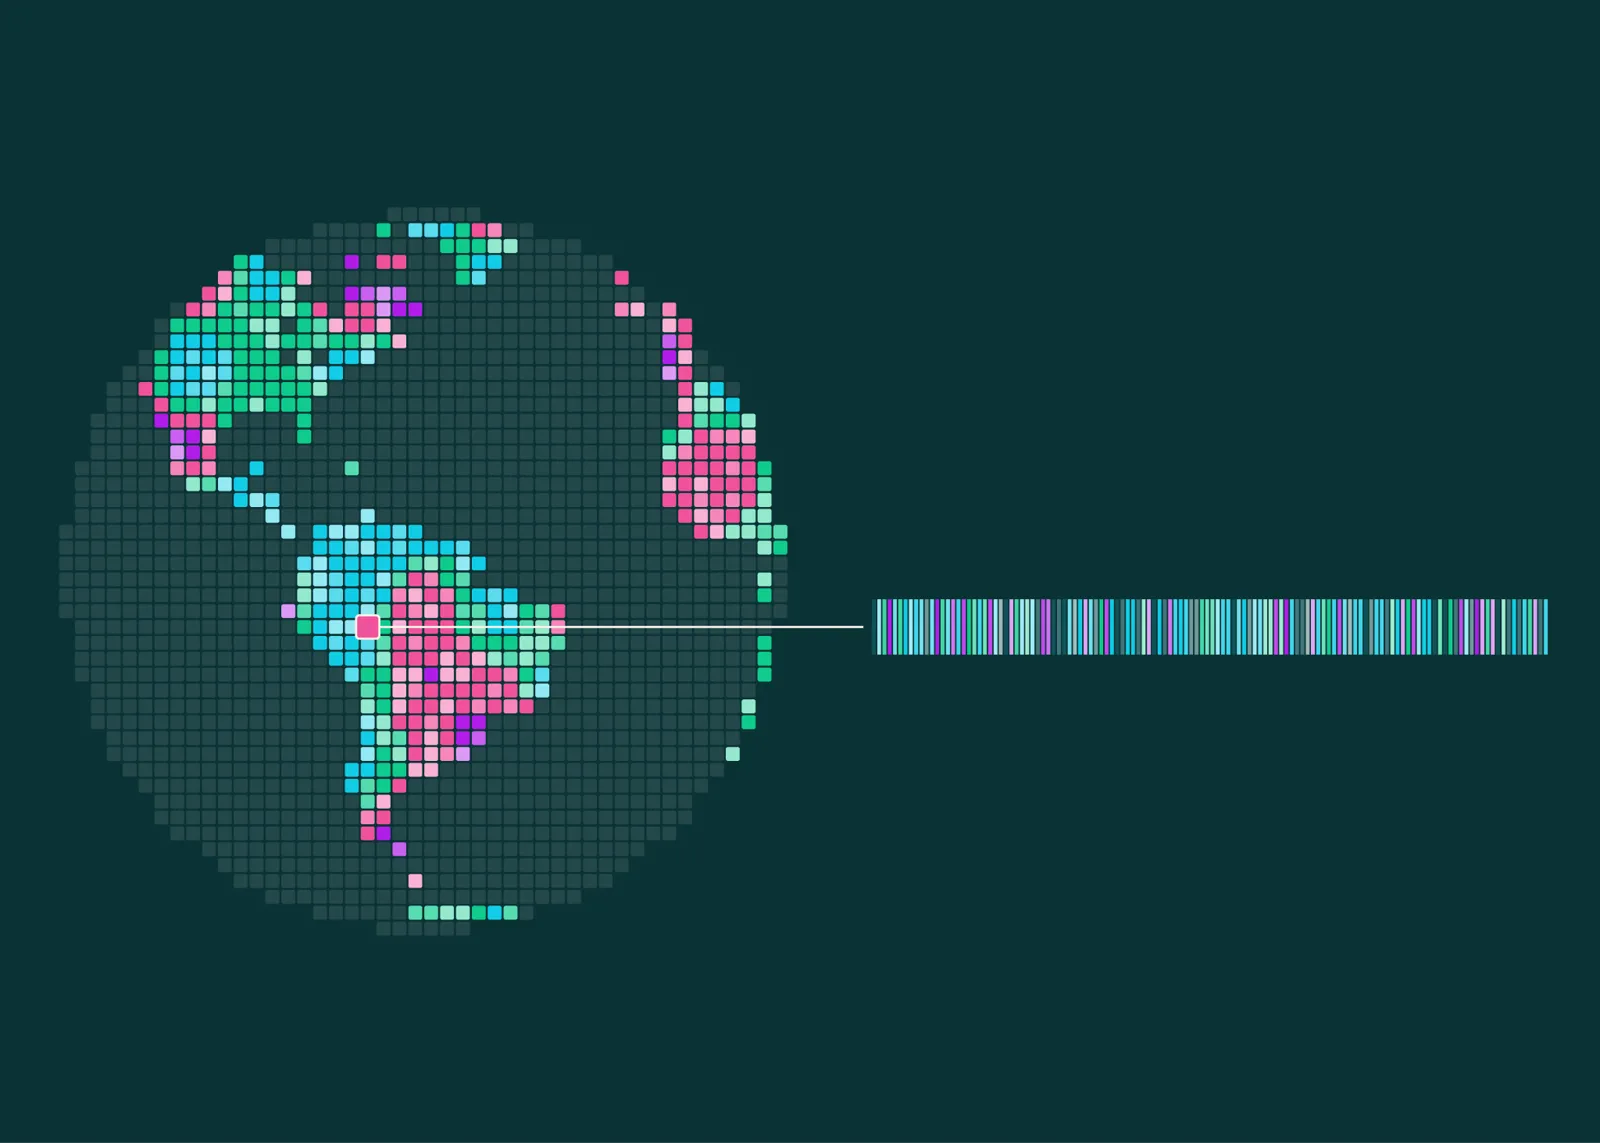
اولموارث ۱.۳؛ امبدینگ ماهوارهای کل کره زمین برای همه
اولموارث ۱.۳ با امبدینگهای سالانه از پیشمحاسبهشده برای کل زمین و یک کاوشگر مرورگری میآید؛ بدون نیاز به GPU و بدون ثبتنام.
ادامهٔ مطلب
ThinkingBox؛ وقتی وضعیت پایگاه داده پاداش آموزش ایجنت میشود
ThinkingBox همان بررسی اجرایی وضعیت نهایی پایگاه داده را به پاداش آموزش تبدیل میکند؛ نتیجه روی Qwen3.8-27B رشد نرخ موفقیت از ۵۱٫۷۰٪ به ۶۰٫۷۸٪ و کاهش دوسوم هزینهٔ کار قابلاعتماد بود.
ادامهٔ مطلب
Granite Speech 5.0؛ سه مدل گفتار IBM برای رونویسی و ترجمه دقیقتر
IBM سه بهروزرسانی در مجموعه Granite Speech معرفی کرد: مدل تازه 2B با پشتیبانی از ۲۰۰۰ واژه کلیدی، Turbo CTC چندزبانه با سرعت ۱.۶ برابر و نسخه Plus با تشخیص بهتر گویندگان.
ادامهٔ مطلب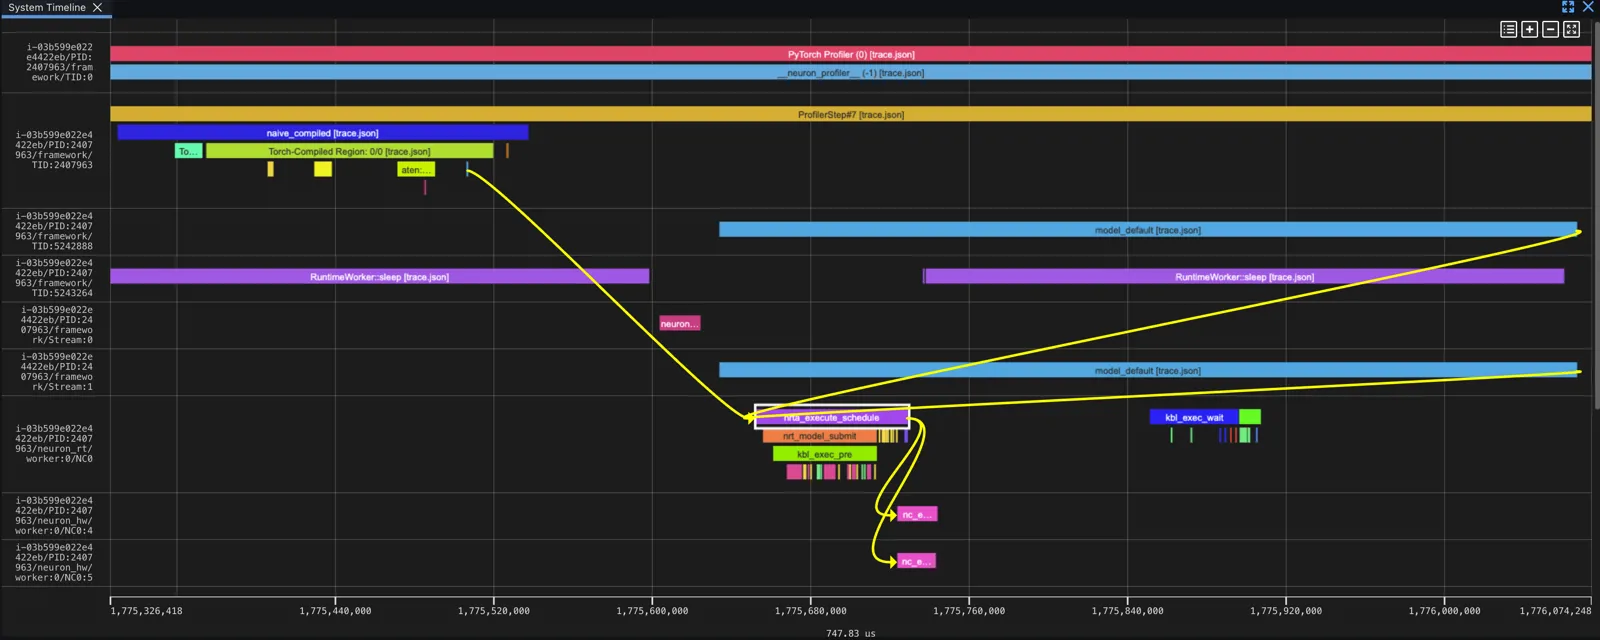
پروفایلینگ TorchNeuron؛ پیدا کردن گلوگاه استنتاج روی Trainium
با torch.profiler و Neuron Explorer میتوانید ببینید هر عملگر چقدر از زمان دستگاه Trainium را میبلعد و چرا ادغام عملیات این هزینه را تا یکششم کم میکند.
ادامهٔ مطلب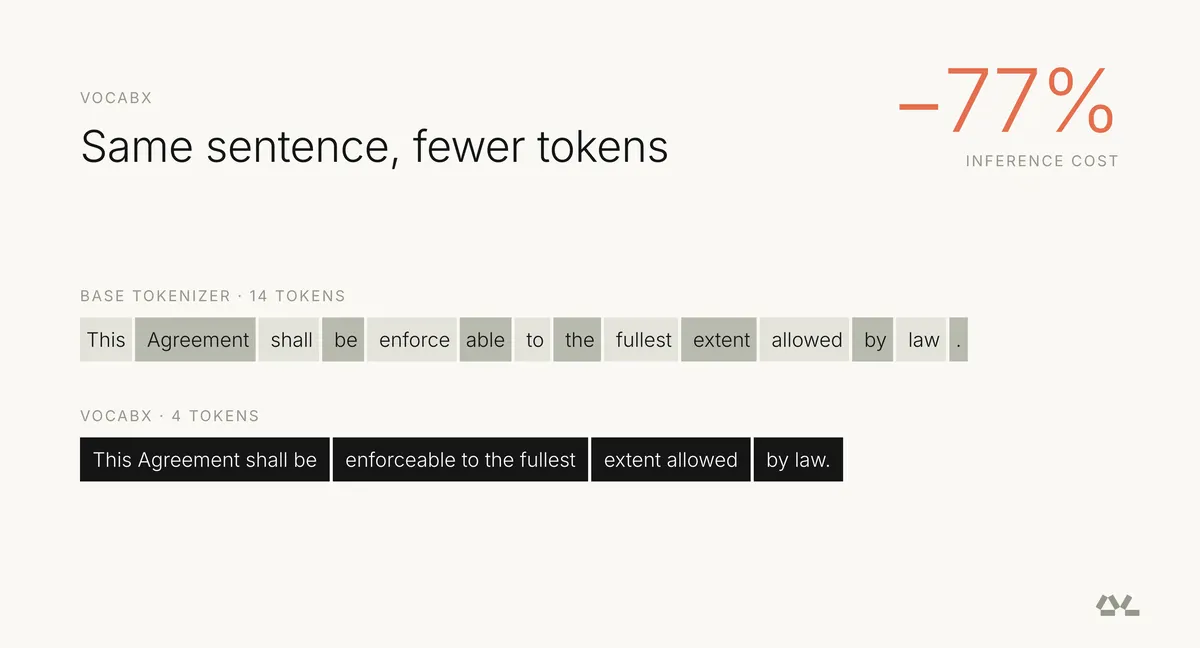
VocabX؛ کاهش ۷۷ درصدی هزینه استنتاج با واژگان تخصصی
VocabX با بازطراحی واژگان مدلهای کوچک و وزندهی بر اساس هزینه هر توکن، هزینه استنتاج یک تصحیحکننده مقاله را ۷۷ درصد کاهش داد؛ بدون تغییر مدل پایه.
ادامهٔ مطلبدر این صفحه مقالهای با این عبارت نیست؛ برای جستجو در همهٔ مقالهها Enter را بزنید.
