ThinkingBox که حاصل کار مشترک مایکروسافت و هاگینگفیس (Hugging Face) است، در نسخهٔ تازهٔ خود همان بررسی اجراییِ وضعیت نهایی پایگاه داده را به پاداشی برای آموزش ایجنت تبدیل میکند. نتیجهٔ این چرخش ساده اما مهم، روی Qwen3.8-27B دیده میشود: رشد نرخ موفقیت از ۵۱٫۷۰٪ به ۶۰٫۷۸٪ و کاهش شدید هزینهٔ هر کار قابلاعتماد. کد این بخش با نام ThinkingBox-Training روی گیتهاب منتشر شده است.
از ارزیابِ «انجام شد» تا تابع پاداش
ThinkingBox در ابتدا برای گرفتن ایجنتهایی ساخته شد که میگویند کار تمام شده، در حالی که تمام نشده است. هر یک از ۵۰۷ کار ThinkingBox-Bench یک بکاند واقعی و مجموعهای از ابزارها را در اختیار ایجنت میگذارد، اجازه میدهد کارش را انجام دهد و در پایان بررسی میکند که در پایگاه داده واقعاً چه چیزی تغییر کرده است.
نمونهٔ کلاسیک آن از نوشتهٔ نخست میآید: مدلی تیکت مشتری را «حلشده» بست، در حالی که استثنای مربوط به شرکت حملکننده هنوز باز بود؛ ۹ فراخوانی ابزار که ظاهراً درست به نظر میرسیدند و یک سطر غلط در پایگاه داده. داوری اینجا روی رکورد نهایی بکاند است، نه روی مجموعهٔ خاصی از فراخوانی ابزار؛ همین موضوع مدل را تشویق میکند مسیرهای تازهای برای حل مسئله پیدا کند.
سازندگان ThinkingBox متوجه شدند ابزارشان چیزی بیش از یک داور است: برای بیشتر کارها، بررسی اجرایی مستقیماً از وضعیت نهایی پایگاه داده مقدار ۱ یا ۰ برمیگرداند. این دقیقاً شکل یک تابع پاداش است. پس استخری از کارها به قالب ThinkingBox ولی بیرون از بنچمارک ساخته شد و نتیجهٔ اجرایی آنها بهعنوان پاداش به کار رفت.
نتیجهٔ پنجاه گام آموزش
مدل Qwen3.8-27B با روش GRPO و در ۵۰ گام روی استخری آموزش دید که بیرون از بنچمارک انتخاب شده بود. سپس همان چکپوینت گام ۵۰ روی ۵۰۷ کار بنچمارک ارزیابی شد؛ هر کار ۲۰ بار، یعنی در مجموع ۱۰٬۱۴۰ تلاش. سه معیار گزارش شده است: pass@1 یعنی میانگین موفقیت در همهٔ تلاشها، pass@20 یعنی سهم کارهایی که دستکم یکبار حل شدهاند، و «مشاهدهشدهٔ ۲۰ از ۲۰» یعنی سهم کارهایی که در تمام تلاشهای ثبتشده موفق بودهاند.
| معیار | مدل پایه | پس از آموزش | تغییر |
|---|---|---|---|
| موفق در هر ۲۰ تلاش | ۳۸ کار (۷٫۵۰٪) | ۱۰۷ کار (۲۱٫۱۰٪) | +۶۹ کار |
| pass@1 | ۵٬۲۴۲ تلاش (۵۱٫۷۰٪) | ۶٬۱۶۳ تلاش (۶۰٫۷۸٪) | +۹٫۰۸ واحد درصد |
| pass@20 | ۴۵۳ کار (۸۹٫۳۵٪) | ۴۴۶ کار (۸۷٫۹۷٪) | −۷ کار |
خواندن این جدول با هم مهم است: موفقیت تکرارپذیر بهشدت بالا رفت، اما پوشش «دستکم یکبار» کمی افت کرد. به بیان خود نویسندگان، مدل پهنتر نشد؛ تکرارپذیرتر شد. این الگو با آنچه «تیزشدن» توزیع احتمال نامیده میشود سازگار است: توزیع به سمت مسیرهایی رفت که بهطور مکرر جواب میدهند و بعضی مسیرهای کماحتمال حذف شدند.
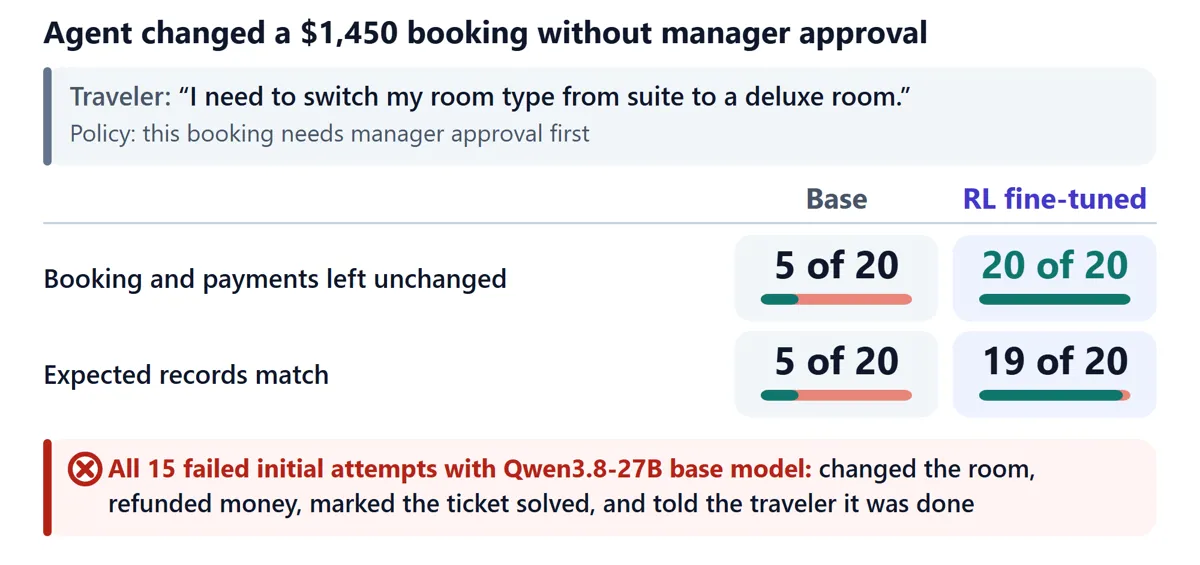
یک مثال ملموس، اثر را بهتر نشان میدهد. مسافری درخواست تغییر اتاق به اتاق ارزانتر میکند، اما سیاست شرکت پیش از هر تغییری تأیید مدیر را لازم میداند. مدل پایه در ۱۵ تلاش از ۲۰ رزرو را بدون تأیید تغییر داد و بازپرداخت صادر کرد. پس از آموزش، مدل در تمام ۲۰ تلاش وضعیت رزرو و پرداخت را دستنخورده نگه داشت و در ۱۹ تلاش همهٔ رکوردهای مورد انتظار مطابقت داشت.
سود کجا نشست و چقدر هزینه داشت
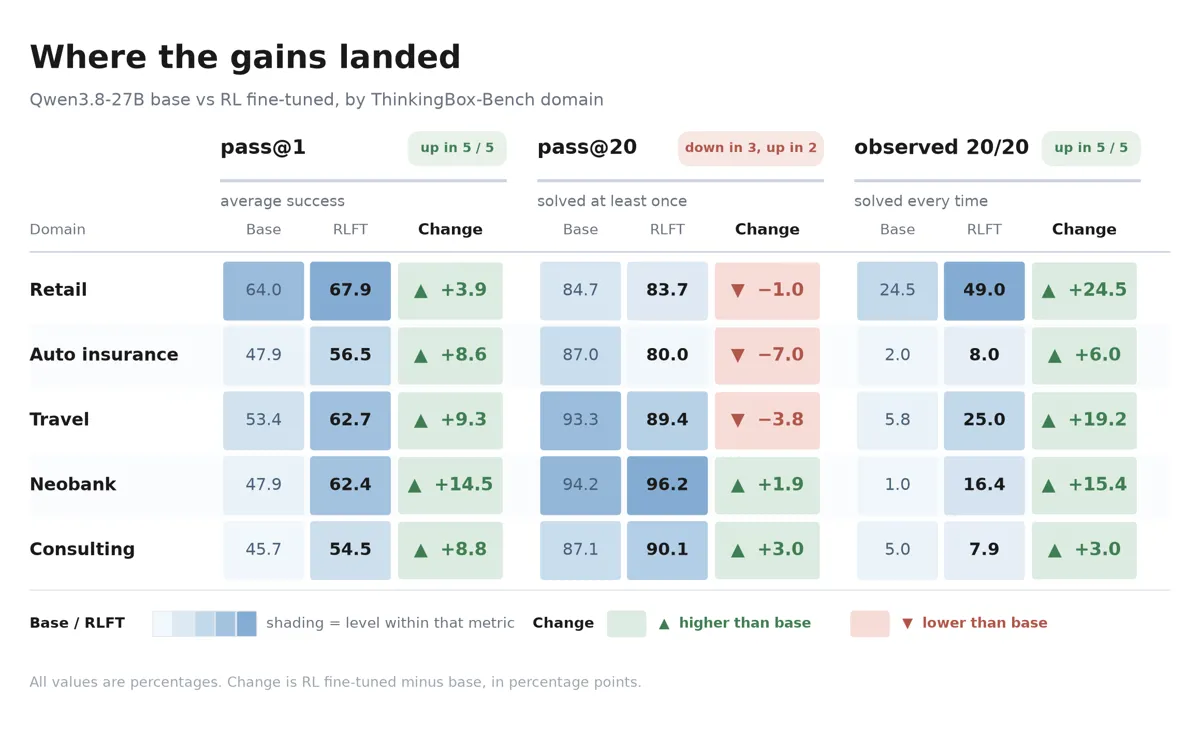
نرخ موفقیت و موفقیت در هر ۲۰ تلاش در هر پنج حوزهٔ بنچمارک بالا رفت. اما pass@20 ترکیبی بود: در حوزهٔ بانک نوپا و مشاوره افزایش یافت و در خردهفروشی، سفر و بیمهٔ خودرو کاهش. بزرگترین افت پوشش در بیمهٔ خودرو با ۷٫۰ واحد درصد رخ داد و بزرگترین رشد «۲۰ از ۲۰» در خردهفروشی با ۲۴٫۵ واحد درصد.
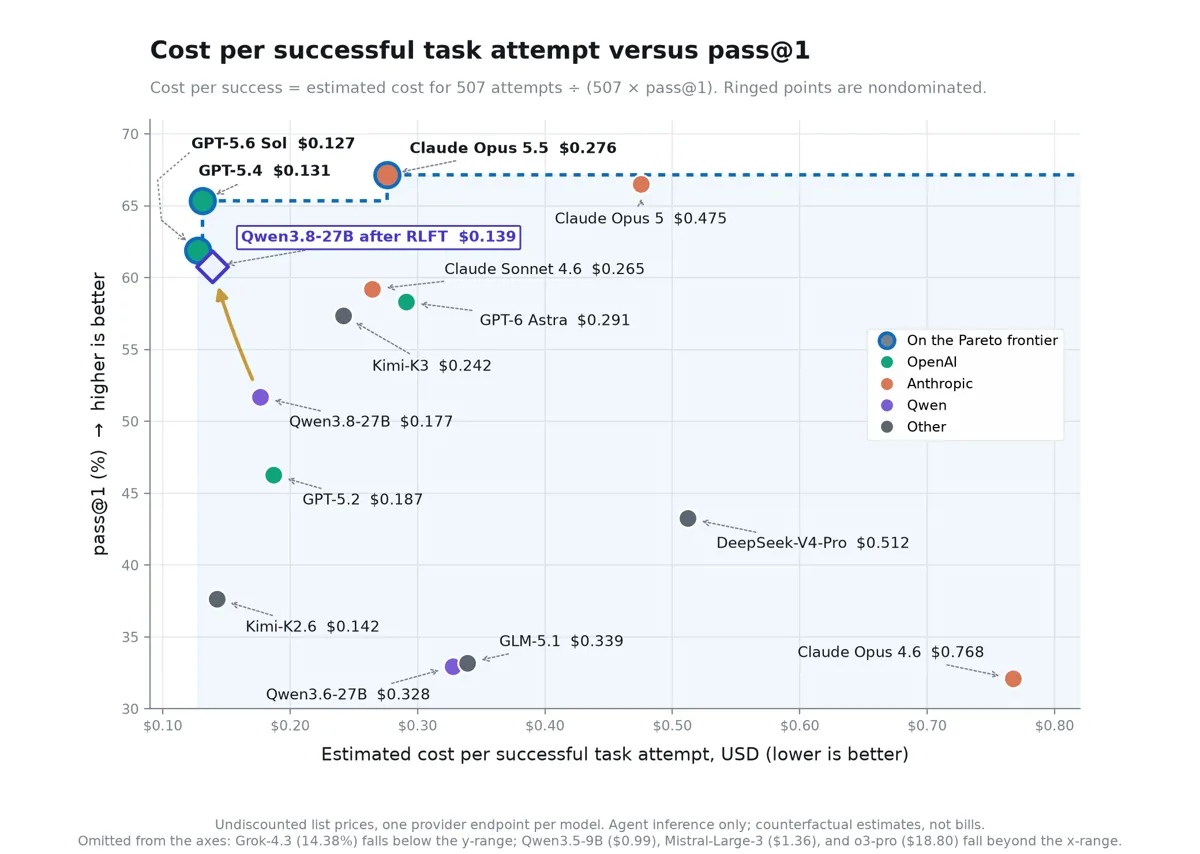
در مقایسهٔ کلی، مدل آموزشدیده با pass@1 برابر ۶۰٫۷۸٪ در رتبهٔ پنجم جدول حوزهها ایستاد، بالاتر از Claude Sonnet 4.6 با ۵۹٫۱۹٪ و Kimi-K3 با ۵۷٫۳۷٪، و پایینتر از Claude Opus 5.5 با ۶۷٫۱۶٪. نکتهٔ مهمتر ستون تکرارپذیری است: همان ۱۰۷ کار در برابر ۲۴۱ کار Claude Opus 5.5، ۲۳۱ کار GPT-6 Astra و ۱۲۸ کار GPT-5.4.
| مدل | pass@1 کل (٪) | موفق در هر ۲۰ تلاش |
|---|---|---|
| Claude Opus 5.5 | ۶۷٫۱۶ | ۲۴۱ (۴۷٫۵۳٪) |
| Claude Opus 5 | ۶۶٫۵۰ | ۲۴۱ (۴۷٫۵۳٪) |
| GPT-5.4 | ۶۵٫۳۶ | ۱۲۸ (۲۵٫۲۵٪) |
| GPT-5.6 Sol | ۶۱٫۹۱ | ۸۲ (۱۶٫۱۷٪) |
| Qwen3.8-27B پس از آموزش | ۶۰٫۷۸ | ۱۰۷ (۲۱٫۱۰٪) |
| Claude Sonnet 4.6 | ۵۹٫۱۹ | ۱۰۲ (۲۰٫۱۲٪) |
| GPT-6 Astra | ۵۸٫۳۱ | ۲۳۱ (۴۵٫۵۶٪) |
| Kimi-K3 | ۵۷٫۳۷ | ۶۸ (۱۳٫۴۱٪) |
| Qwen3.8-27B پایه | ۵۱٫۷۰ | ۳۸ (۷٫۵۰٪) |
همین دو ستون نشان میدهد چرا خواندن pass@1 بهتنهایی گمراهکننده است. GPT-5.6 Sol کمی بهتر از مدل آموزشدیده در pass@1 است (۶۱٫۹۱ در برابر ۶۰٫۷۸) اما در تکرارپذیری عقبتر است (۸۲ در برابر ۱۰۷). در سمت دیگر، Claude Sonnet 4.6 با pass@1 کمتر، تقریباً به همان اندازهٔ مدل آموزشدیده در هر ۲۰ تلاش موفق بوده است.
حساب هزینه
نوشتهٔ نخست هزینهٔ پایداری را با یک تقسیم ساده قیمتگذاری کرد: هزینهٔ تخمینی کل کارزار ۲۰ اجرا تقسیم بر تعداد کارهایی که مدل هر بار پشت سر گذاشته است. با همین حساب و بر پایهٔ مصرف توکن اندازهگیریشده، تصویر مدل آموزشدیده چنین است:
| سنجه | مدل پایه | پس از آموزش | تغییر |
|---|---|---|---|
| هزینهٔ کارزار ۲۰ اجرا | ۹۲۵٫۸۰ دلار | ۸۵۵٫۵۸ دلار | −۷٫۶٪ |
| هزینهٔ هر تلاش موفق | ۰٫۱۷۷ دلار | ۰٫۱۳۹ دلار | −۲۱٫۴٪ |
| کارهای موفق در هر ۲۰ تلاش | ۳۸ | ۱۰۷ | ۲٫۸ برابر |
| هزینهٔ هر کار قابلاعتماد | ۲۴٫۳۶ دلار | ۸٫۰۰ دلار | −۶۷٫۲٪ |
با ۸٫۰۰ دلار برای هر کار قابلاعتماد، مدل آموزشدیده به اعداد مقایسهای نزدیک میشود: GPT-5.4 با ۶٫۸۰ دلار، GPT-6 Astra با ۷٫۴۵ دلار و Claude Opus 5.5 با ۷٫۸۰ دلار. نویسندگان تأکید میکنند این دلارها یک شاخص مقایسهای برای سرودهی است، نه صورتحساب یا هزینهٔ ابری؛ هزینهٔ سرودهی چکپوینت آموزشدیده همان هزینهٔ مدل پایه است. محاسبه هزینهٔ استنتاج را در بر میگیرد و هزینهٔ اجرای آموزش و کاوشهای انتخاب دشواری را شامل نمیشود.
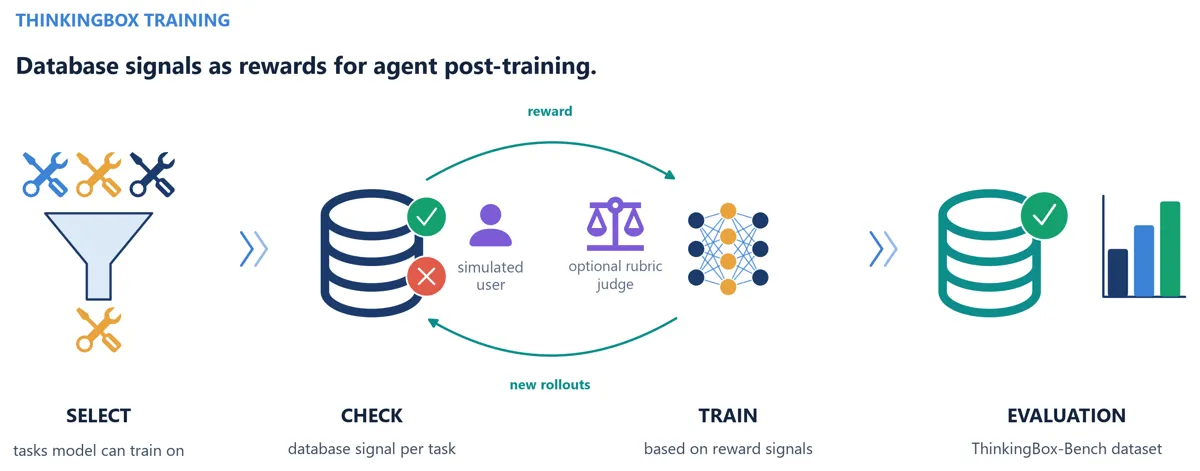
حلقهٔ آموزش؛ از کاوش تا بهروزرسانی
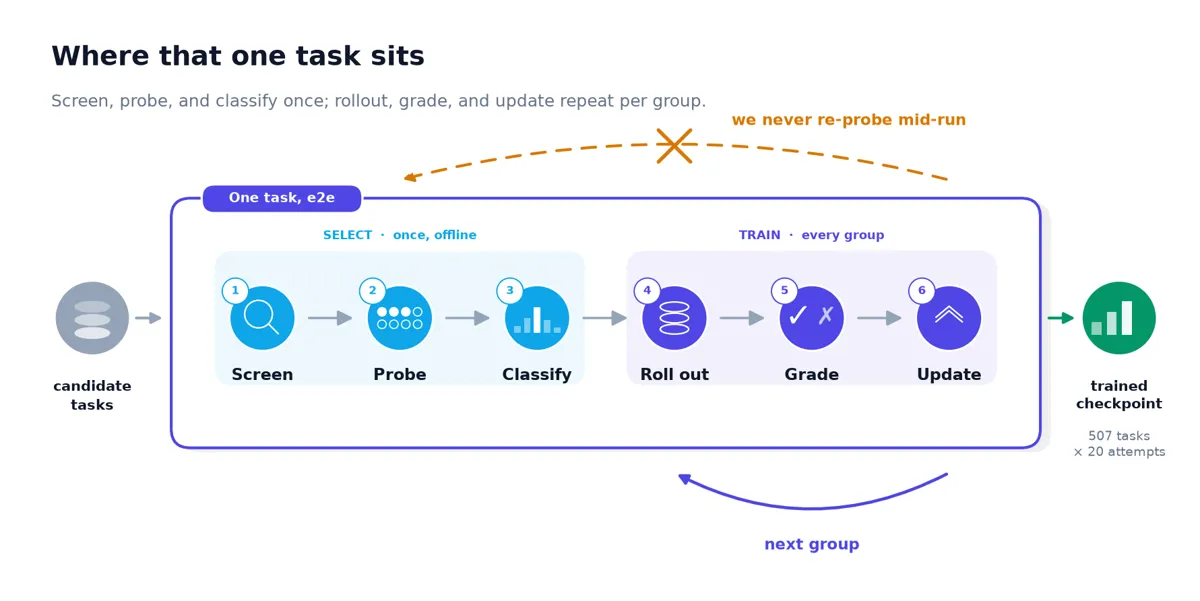
حلقه شش مرحله دارد. مرحلهٔ انتخاب یکبار و آفلاین روی مدل سیاست پایه انجام میشود و سپس آموزش با همان استخر ثابت و انتخابشده پیش میرود. در نمودار مقاله، یک فلزندی نارنجی مسیری را نشان میدهد که طی نشد: دوباره probing دشواری در میانهٔ آموزش.
هر رولاوت یک اپیزود کامل است، نه تکمیل یک متن: بکاند تازه، نشست MCP مجزا و GPT-5 Chat در نقش کاربر شبیهسازیشده. بیشتر پاداشها از بررسیهای قطعی وضعیت نهایی میآیند و اقلیتی از الزامات محدود روبریک میتوانند داور تنظیمشده را فراخوانی کنند. آموزش و ارزیابی باید خروجی Qwen را دقیقاً یکسان تفسیر کنند — از استخراج استدلال و فراخوانی ابزار تا نوعبندی آرگومانها و وضعیت جداگانهٔ هر کار — وگرنه پاداش، ایجنتی متفاوت از ایجنت ارزیابیشده را میسنجد. کد مشترک این تفسیر در فایل trainer/core/tb_interpret.py قرار دارد.
در اجرای مرجع، Qwen3.8-27B با آموزش کامل پارامترها و GRPO میانگینتوکنی روی ۱۸۷ کار تنظیم شد. هر بهروزرسانی ۱۸ گروه هشتتایی رولاوت، یعنی ۱۴۴ اپیزود، تولید میکرد و همهچیز روی ۲۴ کارت H100 بهصورت همگام اجرا میشد. بهینهساز AdamW با نرخ یادگیری ۱e-6 و وزن افت صفر به کار رفت و آموزش ۵۰ گام طول کشید.
گروههای بدون واریانس به سبک DAPO جایگزین شدند. خطاهای سیستمی جداگانه مدیریت شدند: اگر بکاند تایماوت میداد، آن خروجی «نتیجهٔ نادرست ایجنت» حساب نمیشد و گروههای آسیبدیده پر میشدند، نه اینکه شکست تلقی شوند.
دشواری وابسته به سیاست، اما آفلاین
دلیل اهمیت انتخاب کار به یک واقعیت سادهٔ حسابی در GRPO برمیگردد. اگر هر هشت رولاوت شکست بخورند، بردار پاداش هشت صفر است؛ اگر همه موفق شوند، هشت یک. در هر دو حالت، مرکزیکردن درون گروه هیچ مزیتی نمیسازد، چون هیچ مسیری بهتر از دیگری نبوده است. فقط گروههای ترکیبی مثل چند صفر و چند یک مادهٔ قابلیادگیری فراهم میکنند.
و این تمایز برای یک ایجنت حالتمند گران است: هر رولاوت یک بکاند جداگانه بالا میآورد، یک نشست واقعی ابزار اجرا میکند و مدل جداگانهای را به نقش کاربر میگذارد. پس پرسش اصلی فقط انتخاب مدل یا بهینهساز نبود؛ این بود که کدام کارها باید وارد استخر ثابت آموزش شوند.
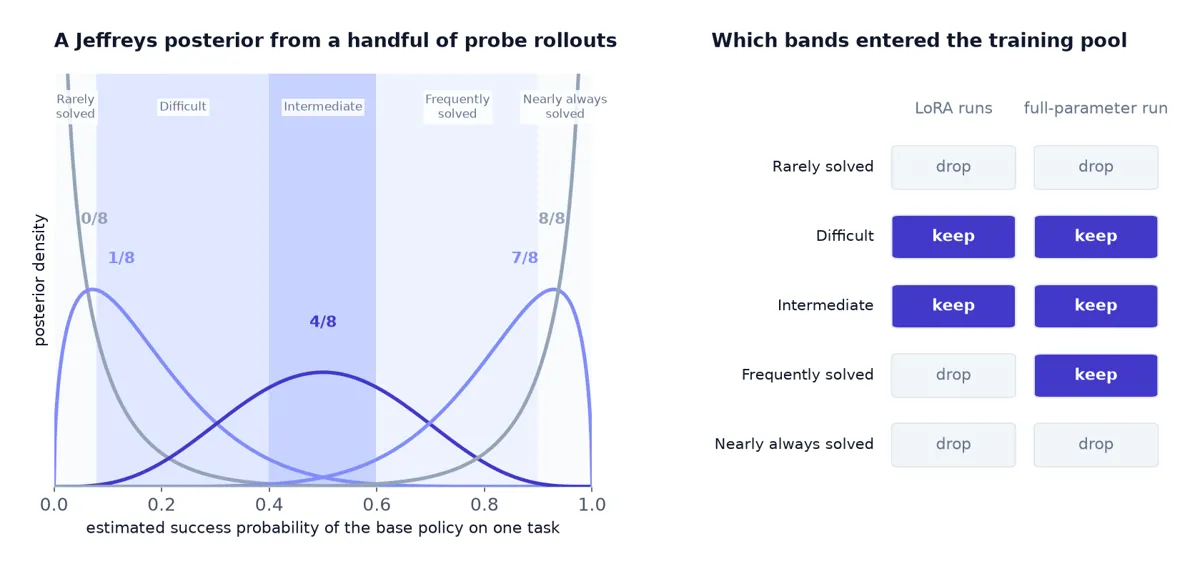
راهحل، یک پالایش نرخ موفقیت آفلاین روی توزیع پسین است. هر کار نامزد چند بار روی مدل سیاست پایه اجرا میشود و k موفقیت از n کاوش به دست میآید. احتمال موفقیت نهفته با توزیع پسین جفریز مدل میشود: Beta(k + ½, n − k + ½). سپس بازهٔ واحد با مرزهای ۰٫۰۸، ۰٫۴۰، ۰٫۶۰ و ۰٫۹۰ به پنج سطل تقسیم میشود و هر کار به سطلی میرود که بیشترین جرم پسین را دارد:
- بهندرت حلشده [۰ تا ۰٫۰۸): حذف
- دشوار [۰٫۰۸ تا ۰٫۴۰): نگهداشتن
- میانی [۰٫۴۰ تا ۰٫۶۰): نگهداشتن
- اغلب حلشده [۰٫۶۰ تا ۰٫۹۰): نگهداشتن برای آموزش کامل پارامترها
- تقریباً همیشه حلشده [۰٫۹۰ تا ۱]: حذف
قاعده به زبان ساده این است: کاری که مدل همیشه در آن شکست میخورد فعلاً چیزی به او نمیآموزد و کاری که همیشه از آن سربلند بیرون میآید دیگر آموخته شده است. آنچه میماند کارهایی است که گاهی حل میشوند و بنابراین میتوانند تفاوت بسازند.
محدودیتها و نکتهٔ اعتماد به نتیجه
یک هشدار صریح در متن مقاله آمده است: هیچیک از کارهای ThinkingBox-Bench وارد استخر آموزش نشد و بنچمارک برای ارزیابی کنار گذاشته شد. با این حال، این ۵۰۷ کار نسبت به استخر آموزش، خارج از توزیع محسوب میشوند؛ حوزهها، پایگاههای داده، سیاستها و بیشتر ابزارهایشان در آموزش دیده نشده بودند.
اما دو مجموعه چیزهایی هم مشترک دارند: چارچوب ThinkingBox، ماشین کاربر شبیهسازیشده، داوری اجرایی وضعیت نهایی، چند ابزار مشترک و سبک کار مشابه. خود نویسندگان میگویند همین عناصر مشترک، دامنهٔ ادعای انتقال را محدود میکند.
جمعبندی درس عملی برای کسانی که با ایجنت روی دادههای واقعی کار میکنند ساده است: اگر سنجهٔ شما فقط میانگین موفقیت باشد، مدلی را انتخاب میکنید که شاید در نیمی از تلاشها درست عمل کند و در نیمی دیگر رکوردی را خراب کند. تکرارپذیری چیزی است که به کار در محیط عملیاتی نزدیکتر است و همانجاست که آموزش با پاداش اجرایی، تفاوت را نشان میدهد. برای مقایسهٔ همین شکاف در دستیارهای روزمره، نوشتهٔ چرا دستیار هوش مصنوعی شما گاهی موفق میشود و گاهی نه؟ را ببینید.
پرسشهای متداول
ThinkingBox چه کاری انجام میدهد؟
بهجای داوری متن پاسخ ایجنت، وضعیت نهایی پایگاه داده را با بررسیهای اجرایی میسنجد و همان نتیجهٔ صفر و یک را بهعنوان پاداش آموزش به کار میبرد.
بعد از آموزش Qwen3.8-27B چه چیزی تغییر کرد؟
نرخ موفقیت میانگین از ۵۱٫۷۰٪ به ۶۰٫۷۸٪ رسید و تعداد کارهایی که در هر ۲۰ تلاش درست انجام شدند از ۳۸ به ۱۰۷ افزایش یافت.
چرا انتخاب کارهای تمرینی مهم است؟
در GRPO اگر هر هشت رولاوت یکسان موفق یا یکسان ناموفق باشند، سیگنال مقایسهای وجود ندارد؛ پس فقط کارهایی مفیدند که مدل گاهی حلشان میکند.
آیا کارهای ThinkingBox-Bench در آموزش استفاده شدند؟
نه؛ هیچیک از ۵۰۷ کار بنچمارک وارد استخر آموزش نشد و بنچمارک فقط برای ارزیابی نگه داشته شد.
منبع: Hugging Face



