مجموعهٔ Granite Speech 5.0 از IBM با یک مدل تازه و دو نسخهٔ بهروزشده منتشر شد؛ ترکیبی که سه نیاز رایج کارهای گفتاری در سازمانها را هدف میگیرد: رونویسی و ترجمهٔ دقیق، رونویسی بسیار سریع روی دستگاه، و ضبطهایی که در آنها اینکه «چه کسی» و «چه زمانی» صحبت کرده بهاندازهٔ خودِ گفتار مهم است.
سه تغییر در یک خانوادهٔ مدل
IBM اعلام کرد که این بهروزرسانیها روی هم طیف کامل کارهای گفتاری سازمانی را پوشش میدهند. هر سه مدل با مجوز Apache 2.0 منتشر شدهاند.
- granite-speech-5.0-2b (جدید): رونویسی خودکار گفتار (ASR) دقیقتر و مقاومتر در برابر نویز و پژواک، هدایت زبان ورودی از طریق پرامپت، بایاس واژههای کلیدی تا ۲٬۰۰۰ اصطلاح و ترجمهٔ بهتر برای گفتار طولانی.
- granite-speech-5.0-470m-turboctc (بهروزشده): چندزبانه، با نقطهگذاری و بزرگحرفنویسی بومی و مقاومت بیشتر در برابر نویز و پژواک.
- granite-speech-4.1-2b-plus (بهروزشده): تشخیص بهتر گوینده، زمانبندی دقیقتر، بایاس واژههای کلیدی و عملکرد بهتر در گفتارهای طولانی.
granite-speech-5.0-2b؛ دقت بیشتر و کنترل روی واژگان
این مدل جانشین granite-speech-4.1-2b با همان تعداد پارامتر است. زبانهای پشتیبانیشده برای رونویسی عبارتاند از انگلیسی، فرانسوی، آلمانی، اسپانیایی، پرتغالی و ژاپنی؛ ترجمه به و از انگلیسی هم در همین زبانها انجام میشود و ترجمه از انگلیسی به ایتالیایی و ماندارین نیز در فهرست است. به گفتهٔ IBM، مدل روی ۳۹۰٬۰۰۰ ساعت صدای عمومی و همچنین دادهٔ ساختگی برای رونویسی ژاپنی، بایاس واژههای کلیدی و ترجمه آموزش دیده است.
چه چیزی نسبت به نسخهٔ ۴.۱ تغییر کرده است؟
- رونویسی انگلیسی دقیقتر: دقت بالاتر در بنچمارکهای کوتاه انگلیسی و رفتار بهتر در نویز، پژواک و گفتار با میکروفن دور.
- هدایت با شناسهٔ زبان: میتوان زبان ورودی را در پرامپت مشخص کرد تا رونویسی چندزبانه جهت بگیرد.
- ترجمهٔ بهتر برای گفتار طولانی و محاورهای: کیفیت ترجمه در جملات بلندتر و گفتار طبیعیتر حفظ میشود، نه فقط در جملات کوتاه خواندهشده.
- فهرست واژههای کلیدی تا ۲٬۰۰۰ اصطلاح: رونویسی و ترجمه را میتوان به سمت نام محصولات، نام افراد و سرواژهها در همهٔ زبانهای پشتیبانیشده متمایل کرد.
- نقطهگذاری و بزرگحرفنویسی در صورت درخواست: کافی است خروجی قالبتشده را در پرامپت بخواهید؛ F1 بزرگحرفنویسی در مجموعههای آزمون بین 89.7 تا 99.5 گزارش شده است.
این مدل در Transformers، vLLM، llama.cpp و mlx-audio برای تراشههای اپل (Apple Silicon) پشتیبانی میشود.
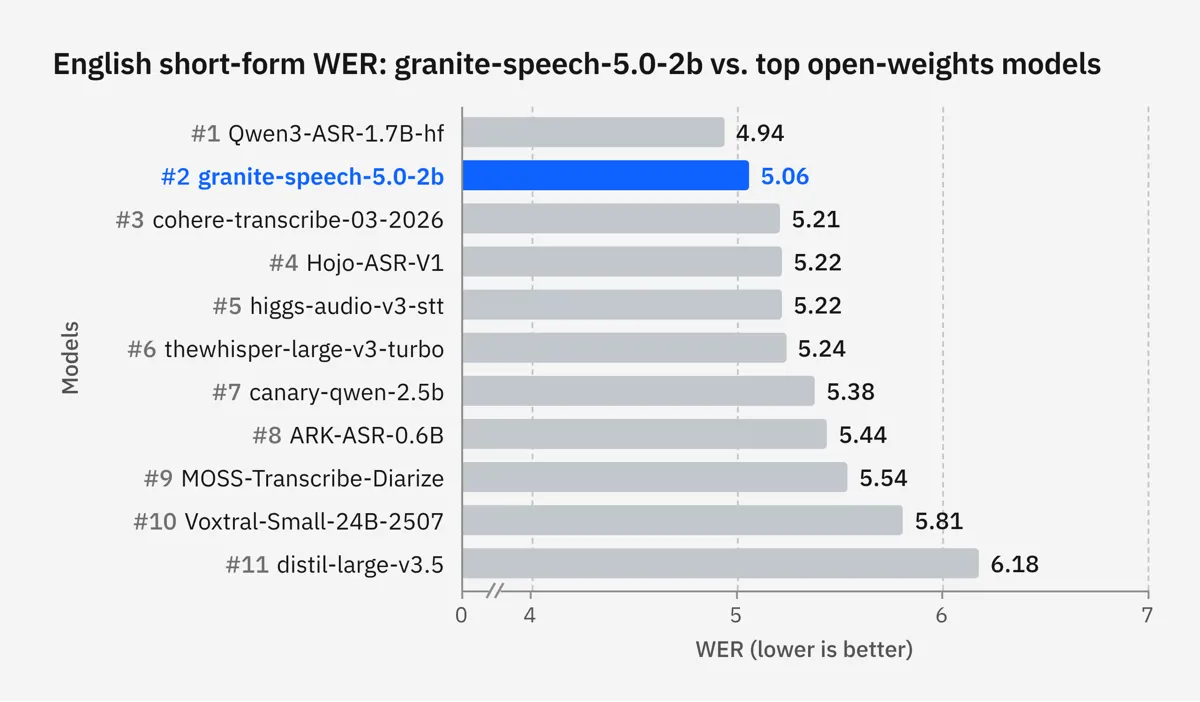
بر اساس اعلام IBM، granite-speech-5.0-2b در میان مدلهای باز برتر ASR از نظر میانگین نرخ خطای واژه (WER) انگلیسی رتبهٔ دوم را دارد؛ میانگین WER این مدل 5.06 درصد است و عدد کمتر بهتر محسوب میشود. این نتایج رسمی و مربوط به ۲۱ اکتبر ۲۰۲۶ است و میانگینگیری روی مجموعههای آزمون عمومی کوتاه انگلیسی در لیدربورد Open ASR انجام شده است.
Turbo CTC؛ حالا چندزبانه و ۱.۶ برابر سریعتر
هنگام معرفی Turbo CTC در ماه اوت، این مدل یک رمزگذار ۴۷۰ میلیون پارامتری تنها انگلیسیزبان بود که برای سرعت ساخته شده بود. نسخهٔ بازنگریشده همان ابعاد را نگه میدارد و سه خواستهٔ اصلی کاربران را اضافه میکند:
- رونویسی چندزبانه: انگلیسی، ژاپنی، اسپانیایی، آلمانی، فرانسوی، ایتالیایی و پرتغالی.
- نقطهگذاری و بزرگحرفنویسی بومی: متن خروجی آمادهٔ خواندن است و به مرحلهٔ جداگانهٔ نقطهگذاری یا اصلاح حروف نیاز ندارد.
- مقاومت بیشتر در شرایط صوتی دشوار: آموزش هدفمند روی صدای پژواکی، عملکرد مدل را در اتاقهای پرانعکاس و ضبطهای دوربرد بهتر میکند.
سرعت هم افزایش یافته است. IBM با کامپایل یک بلوک Conformer و استفادهٔ دوباره از گراف آن در کل پشته، زمان warmup را کاهش داده و Turbo CTC را در لیدربورد Open ASR به 19,870 RTFx رسانده است؛ این عدد در زمان معرفی حدود 12,600 RTFx بود، یعنی حدود ۱.۶ برابر سریعتر با همان سطح دقت.
granite-speech-4.1-2b-plus؛ چه کسی گفت و کِی گفت
نسخهٔ بهروزشدهٔ granite-speech-4.1-2b-plus برای همان ضبطهایی تنظیم شده که سازمانها واقعاً در اختیار دارند: جلسات، تماسهای پشتیبانی و مصاحبههای چندگوینده و طولانی. نام 4.1 حفظ شده چون معماری، قالب پرامپت و API تغییری نکرده و این مدل جایگزین مستقیم نسخهٔ فعلی با وزنهای بهبودیافته است. چهار حوزه بهتر شدهاند:
- تشخیص گوینده: برچسبگذاری دقیقتر اینکه چه کسی صحبت میکند؛ نرخ خطای دیاریزاسیون در سطح واژه (WDER) ۷ درصد و نرخ خطای واژه با انتساب گوینده (cpWER) نیز بهطور کلی ۷ درصد کاهش یافته است.
- زمانبندی: میانگین جابهجایی زمانبندی (AAS) بیش از نصف کم شده و زمانبندی در زیرنویس، جستوجو و بازبینی دقیقتر است.
- گفتار طولانی: WER روی مجموعههای آزمون گفتار طولانی ۲۴ درصد کاهش یافته است.
- بایاس واژههای کلیدی: خطا روی واژههای بایاسشده با فهرستهای ۲۰ اصطلاحی ۴۵ درصد کمتر شده است.
| قابلیت | سنجه | نسخهٔ قبلی | نسخهٔ بهروزشده |
|---|---|---|---|
| زمانبندی، همهٔ گفتار | AAS | 210.86 | 98.54 |
| زمانبندی، گفتار کوتاه | AAS | 29.27 | 26.20 |
| بایاس واژههای کلیدی | WER واژههای بایاسشده، فهرست ۲۰ اصطلاحی | 11.79 | 6.48 |
| گفتار طولانی | WER مجموعههای آزمون گفتار طولانی | 13.53 | 10.22 |
| تشخیص گوینده | WDER | 4.40 | 4.10 |
| رونویسی با انتساب گوینده | cpWER | 30.50 | 28.48 |
همهٔ این سنجهها نرخ خطا هستند، پس عدد کمتر بهتر است. جزئیات کامل نتایج در کارت مدل آمده است.
کدام مدل را انتخاب کنیم؟
IBM برای انتخاب سریع، سه مسیر پیشنهاد میکند:
- اگر دقت بالای رونویسی، ترجمه یا بایاس واژههای کلیدی میخواهید، سراغ granite-speech-5.0-2b بروید.
- اگر سرعت خام یا رونویسی روی دستگاه مهم است، granite-speech-5.0-470m-turboctc انتخاب درست است؛ نسخهٔ نمایشی جریانی WebGPU آن هم در مرورگر قابل آزمودن است.
- اگر با جلسات و تماسهای چندگوینده کار میکنید، granite-speech-4.1-2b-plus مناسبتر است.
هر سه مدل با مجوز Apache 2.0 و پشتیبانی بومی در Transformers منتشر شدهاند و نتایج کامل ارزیابی، جزئیات معماری، دادهٔ آموزش و نمونههای استفاده در کارت هر مدل موجود است. IBM همچنین توصیه میکند برای استقرارهای عملیاتی که به تشخیص ریسک بیشتری نیاز دارند، این مدلها را با Granite Guardian همراه کنید.
برای مقایسه با دیگر مدلهای خانوادهٔ Granite میتوانید نوشتهٔ Granite Switch 4.1 را بخوانید؛ اگر هم موضوع بایاس واژگان تخصصی در استنتاج برایتان مهم است، مطلب VocabX و کاهش هزینهٔ استنتاج با واژگان تخصصی زمینهٔ مرتبطی دارد.
پرسشهای متداول
مدل Granite Speech 5.0 از چه زبانهایی پشتیبانی میکند؟
مدل granite-speech-5.0-2b انگلیسی، فرانسوی، آلمانی، اسپانیایی، پرتغالی و ژاپنی را رونویسی میکند و در همین زبانها ترجمه به و از انگلیسی انجام میدهد؛ ترجمه از انگلیسی به ایتالیایی و ماندارین هم پشتیبانی میشود.
کدام مدل برای رونویسی سریع یا روی دستگاه مناسب است؟
IBM برای سرعت بالا و رونویسی روی دستگاه، granite-speech-5.0-470m-turboctc را پیشنهاد میکند که در نسخه تازه چندزبانه شده و به 19,870 RTFx در لیدربورد Open ASR رسیده است.
مدل 4.1-2b-plus چه تغییری کرده است؟
این نسخه با معماری و قالب پرامپت و API یکسان منتشر شده و جایگزین مستقیم مدل قبلی است؛ خطای تشخیص گوینده و خطای واژههای کلیدی هرکدام حدود ۷ و ۴۵ درصد کاهش یافته و خطای رونویسی گفتار طولانی ۲۴ درصد کمتر شده است.
مجوز استفاده از این مدلها چیست؟
هر سه مدل با مجوز Apache 2.0 منتشر شدهاند و پشتیبانی بومی در Transformers دارند.
منبع: Hugging Face



