پروفایلینگ TorchNeuron روی AWS Trainium نشان میدهد چرا یک مدل کند است و زمان دقیقاً کجا خرج میشود. در این راهنما، با یک عملیات کوچک به نام RMSNorm جلو میرویم و سه پیادهسازی متفاوت آن را با ابزارهای پروفایلینگ پایتورچ و Neuron Explorer مقایسه میکنیم.
خیلی از متخصصان یادگیری ماشین حس خوبی دارند که چطور یک مدل را سریع اجرا کنند، اما کمتر میدانند چطور تحلیل کنند که چرا مدل کند است. این نوشته از صفر شروع میشود و هیچ تجربهٔ قبلی در پروفایلینگ نمیخواهد. تراشهٔ مورد استفاده AWS Trainium است؛ تراشهای که مخصوص بارهای آموزش و استنتاج یادگیری عمیق ساخته شده و بکاند متنباز بومی پایتورچ آن TorchNeuron نام دارد.
TorchNeuron از جریانهای استاندارد پایتورچ روی Trainium پشتیبانی میکند: اجرای eager، مسیر torch.compile و APIهای معمول پایتورچ، با کمترین تغییر در کد. همچنین به رابط هستهٔ Neuron (NKI) وصل میشود تا اپراتورهای سفارشی و بهینهسازی عملکرد ممکن شود. پیش از این هم نوشتهای دربارهٔ اجرای مدلهای هوگینگفیس روی AWS Trainium با TorchNeuron منتشر کردهایم.
بکاند Neuron چطور داخل پایتورچ مینشیند؟
پیش از پروفایل کردن، بهتر است بدانیم Neuron چگونه با پایتورچ یکپارچه میشود. بکاند Neuron از نقطهٔ توسعهٔ PrivateUse1 در پایتورچ استفاده میکند. این سازوکار اجازه میدهد یک شتابدهنده بدون افزودن کلید ارسال اختصاصی (مثل cuda) با فریمورک یکپارچه شود. بستهٔ torch_neuronx همراه با پایتورچ بالادستی، Neuron را بهعنوان یک بکاند بومی برای کد پایتورچ ثبت میکند.
راهاندازی پروفایلر
برای پروفایل کردن یک بار کاری روی Neuron به دو شیء نیاز دارید:
- NeuronConfig: تعیین میکند کدام جریان داده و کدام NeuronCoreها ثبت شوند و خروجی کجا نوشته شود. این شیء بهعنوان experimental_config به torch.profiler.profile پاس داده میشود.
- NeuronProfiler: یک NeuronConfig میگیرد و تابع بازگشتی export_trace را فراهم میکند. این تابع رد فریمورک را در فایل trace.json و در کنار ردهای سیستمی Neuron مینویسد.
پارامتر modes جریانهای دادهای مثل دستورهای دستگاه و ردهای رانتایم را انتخاب میکند. پارامتر capture_enabled_for_nc مشخص میکند کدام NeuronCoreها ردیابی شوند. اگر correlate_device_time=True باشد، زمان دستگاه از رد به جدول key_averages() منتقل میشود و میتوانید زمان CPU و زمان دستگاه Neuron را کنار هم بسنجید.
دو نکتهٔ فنی که بدون آنها نتیجه ناقص میشود: در فهرست فعالیتها باید ProfilerActivity.PrivateUse1 را اضافه کنید تا فعالیت دستگاه Neuron جمعآوری شود، و درون حلقهٔ پروفایل torch.neuron.synchronize() را صدا بزنید. بدون این همگامسازی، ممکن است پروفایلر پیش از پایان کار دستگاه خروجی بگیرد و ستون زمان Neuron خالی بماند. زمانبندی نمونه در این راهنما با wait=2، warmup=1 و active=1 در چهار فراخوانی prof.step() تنظیم شده تا یک تکرار گرم ثبت شود و سرباز اولیهٔ راهاندازی در نتیجه نیاید.
جدول key_averages را چطور بخوانیم؟
بعد از پایان پروفایلینگ، جدول key_averages() را بررسی کنید. اگر بر اساس self_privateuse1_time_total مرتب کنید، عملگرهایی که بیشترین هزینهٔ دستگاه را دارند بالای جدول میآیند. خروجی کامل این جدول رویدادهای سمت CPU مثل تخصیص حافظه و انتقال از میزبان به دستگاه را هم شامل میشود؛ بنابراین برای تمرکز روی محاسبه، فهرست را به عملگرهای RMSNorm محدود میکنیم.
نمونهٔ اول: RMSNorm با عملیات خام پایتورچ
در این پیادهسازی، هر خط تابع به یک یا چند عملگر ATen نگاشت میشود و میتواند تنسور میانی بسازد: مربع گرفتن، میانگین روی آخرین بُعد، وارون جذر میانگین، و در آخر ضرب در وزن.
| نام | تعداد فراخوانی | زمان CPU | زمان دستگاه Neuron | سهم از زمان دستگاه |
|---|---|---|---|---|
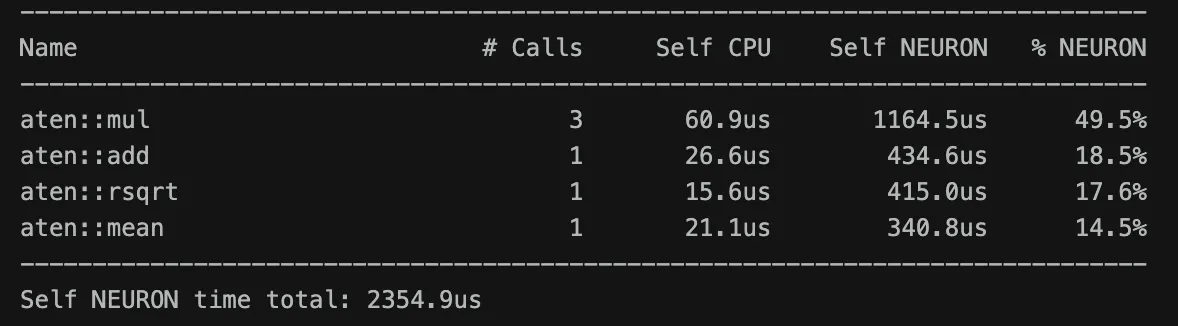
| aten::mul | 3 | 60.9 میکروثانیه | 1,164.5 میکروثانیه | 49.5% |
| aten::add | 1 | 26.6 میکروثانیه | 434.6 میکروثانیه | 18.5% |
| aten::rsqrt | 1 | 15.6 میکروثانیه | 415.0 میکروثانیه | 17.6% |
| aten::mean | 1 | 21.1 میکروثانیه | 340.8 میکروثانیه | 14.5% |
مجموع زمان دستگاه در این حالت 2.355 میلیثانیه است. هر ردیف مستقیماً به بخشی از تابع نگاشت میشود: aten::mul برای x * x، ضرب در rms و ضرب نهایی در وزن اجرا میشود. aten::mean آخرین بُعد را کاهش میدهد. aten::add مقدار اپسیلون را اضافه میکند و چون این مقدار اسکالر از سمت CPU میآید، یک کپی از میزبان به دستگاه را هم راه میاندازد. aten::rsqrt هم وارون جذر را حساب میکند.
Neuron Explorer: دیدن مسیر یک عملگر
Neuron Explorer یک نمایشگر مرورگری برای رد سیستمی، خط زمانی دستگاه و تفکیک هر موتور است. به آن میتوان از طریق تونل SSH یا افزونهٔ Visual Studio Code دسترسی داشت. در این نوشته از Explorer استفاده میکنیم تا آنچه را جدول key_averages() بهصورت عددی گزارش میدهد تأیید کنیم و ببینیم بین دو ارسال چه اتفاقی میافتد.
بعد از پروفایلینگ، پوشهٔ خروجی رد سیستمی و — اگر داده دستگاه را ثبت کرده باشید — فایلهای جفتشدهٔ .neff و .ntff را در خود دارد. قالب فایل اجرایی Neuron (NEFF) اجراپذیر کامپایلشده را نگه میدارد و NTFF متناظر، رد دستورهای سختافزاری آن است؛ این دو یک هش عددی مشترک دارند که نشان میدهد جفت هستند. برای باز کردن پروفایل سیستم یا ترکیبی، کل پوشهٔ خروجی را آپلود میکنید. برای پروفایل فقط دستگاه، باید فایلهای همنام .neff و .ntff را جداگانه بارگذاری کنید.
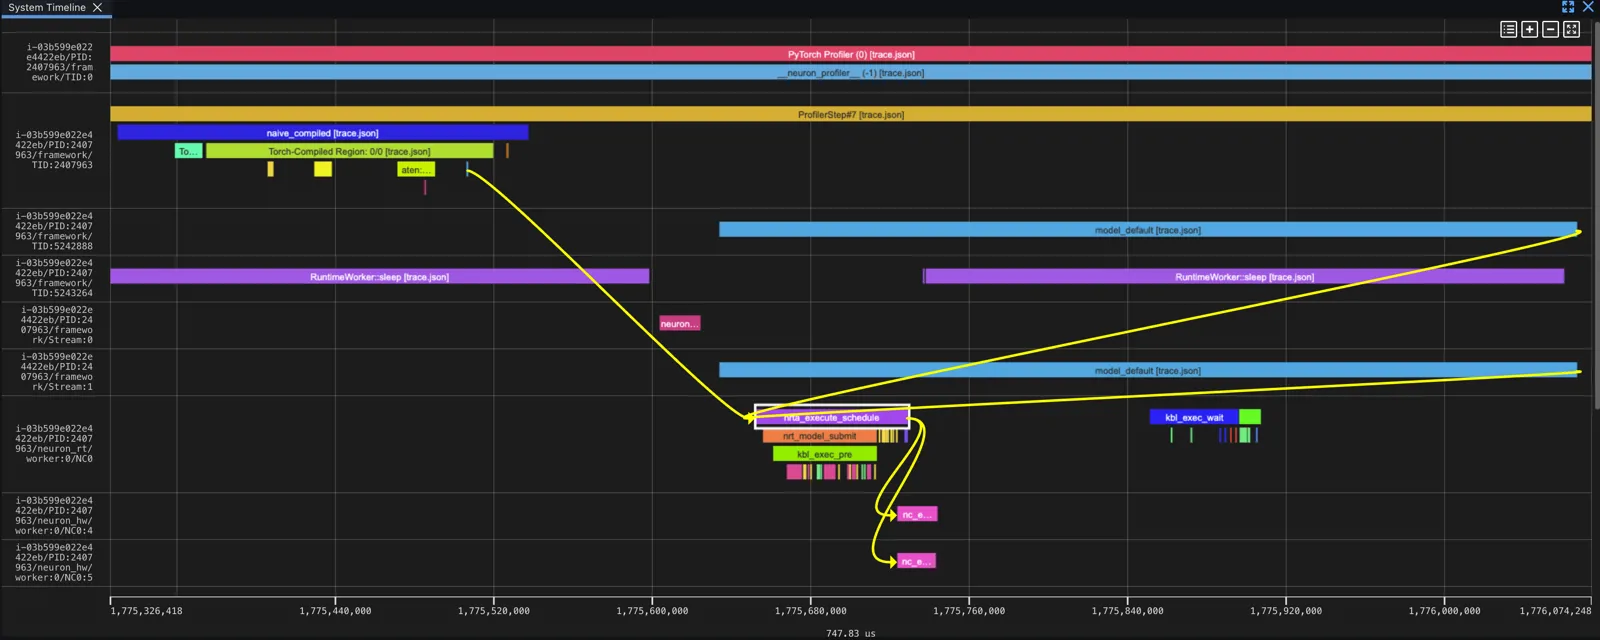
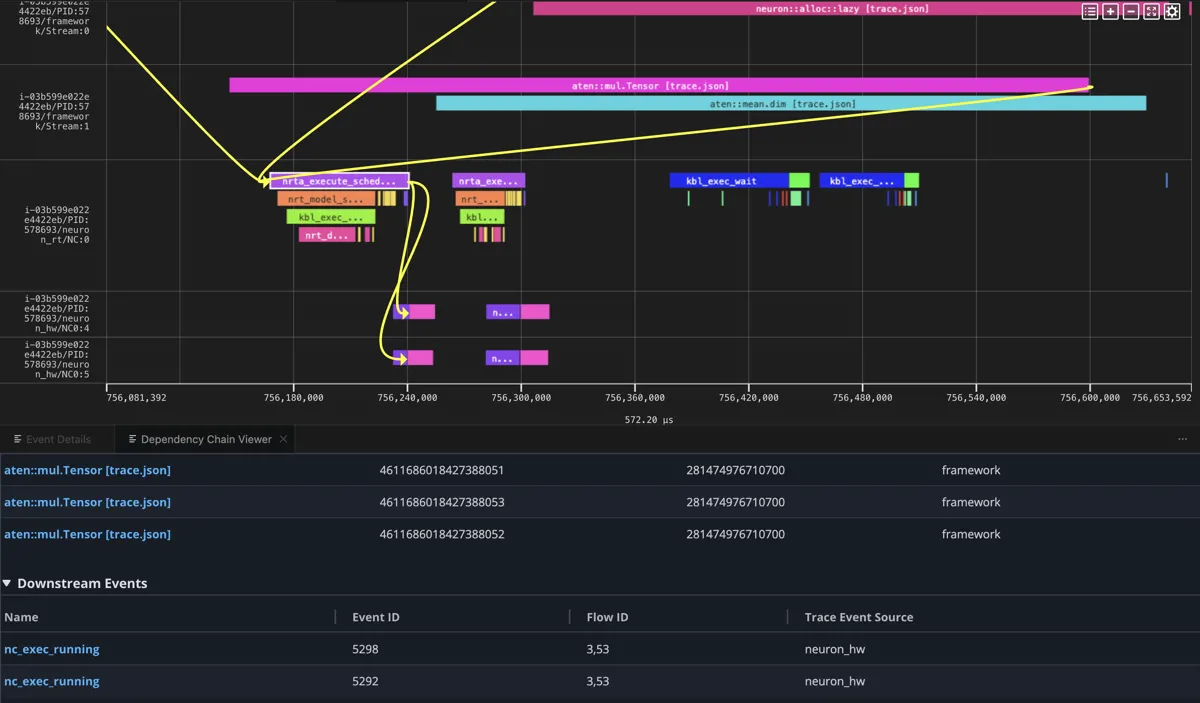
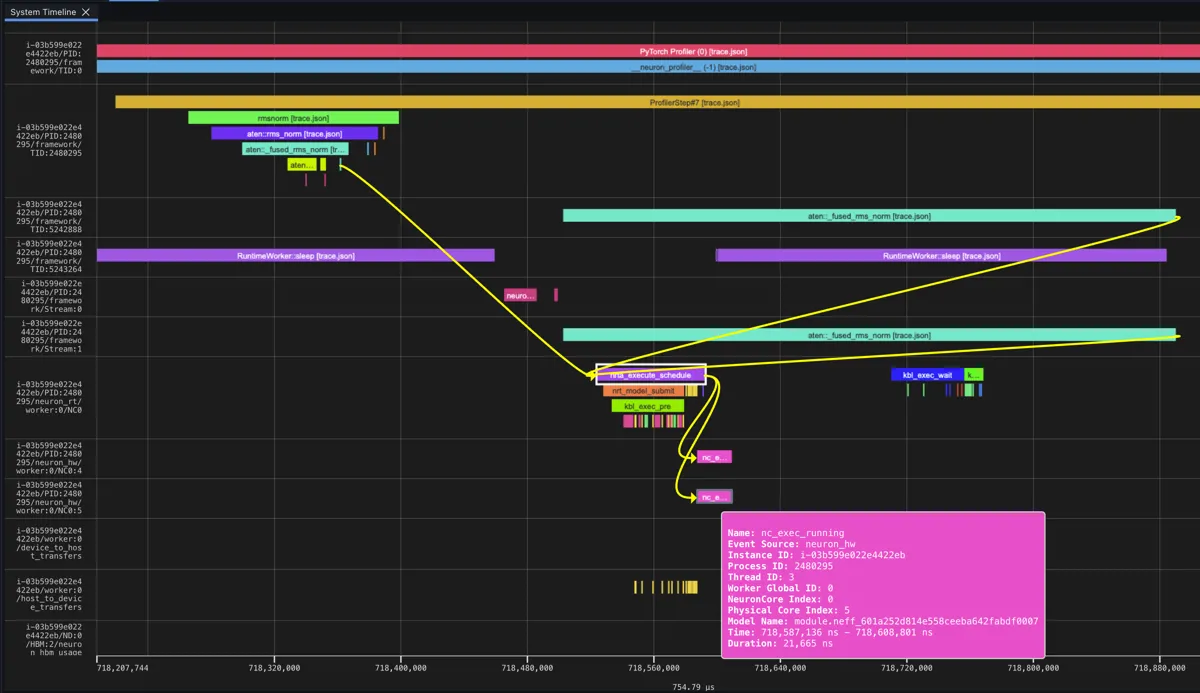
در Explorer زمان از چپ به راست و چرخهٔ حیات رویدادها از بالا به پایین جریان دارد. هر عملگر ATen همین الگو را طی میکند: ساختهشدن در لاین فریمورک، زمانبندی در لاین رانتایم با نام nrta_execute_schedule، و اجرا در لاین سختافزار با نام nc_exec_running.
| لاین | پسوند برچسب | چه چیزی را نشان میدهد |
|---|---|---|
| ارسال فریمورک | framework/TID:<id> | رویدادهای ارسال عملگر (رانتایم PrivateUse1) به تفکیک شناسهٔ نخ |
| دستگاه فریمورک | framework/Stream:<n> | رویدادهای تعامل با دستگاه (درایور PrivateUse1) به تفکیک شمارهٔ جریان |
| رانتایم Neuron | neuron_rt/NC:<n> | فراخوانیهای API رانتایم Neuron، به تفکیک NeuronCore منطقی |
| سختافزار Neuron | neuron_hw/NC<n>:<id> | رویدادهای اجرای سختافزاری، به تفکیک NeuronCore فیزیکی |
در حالت eager هر عملگر مستقل اجرا میشود. با نمایشگر زنجیرهٔ وابستگی میتوانید یک aten::mul.Tensor را از لایهٔ فریمورک تا زمانبندی رانتایم و اجرا روی دستگاه دنبال کنید.
نمونهٔ دوم: torch.rms_norm
حالا عملیات جداگانه را با تابع داخلی torch.rms_norm جایگزین میکنیم. Neuron این عملیات را به یک هستهٔ ادغامشده پایین میآورد. نتیجه در جدول چنین میشود:
| نام | تعداد فراخوانی | زمان CPU | زمان دستگاه Neuron | سهم از زمان دستگاه |
|---|---|---|---|---|
| aten::_fused_rms_norm | 1 | 47.6 میکروثانیه | 403.3 میکروثانیه | 100% |
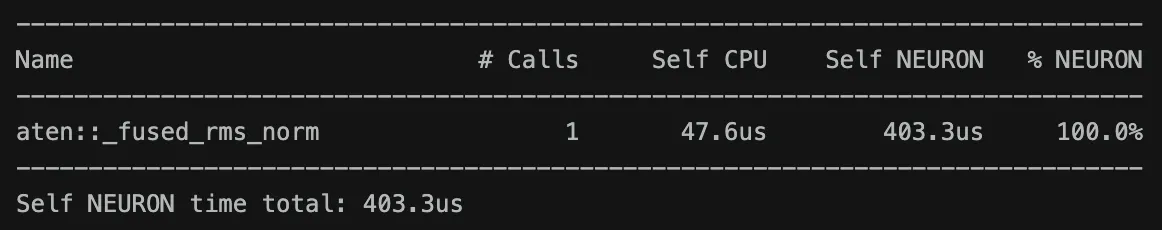
در پیادهسازی خام، هر عملگر جداگانه از مرز ارسال عبور میکرد و مسیر خودش را از فریمورک به رانتایم و سختافزار طی میکرد. در نسخهٔ ادغامشده، یک فراخوانی پایتون کل محاسبه را پوشش میدهد؛ رد شامل یک ارسال و یک رویداد سختافزاری است، بدون فاصله میان اجزای محاسبه.
نمونهٔ سوم: عملیات خام با torch.compile
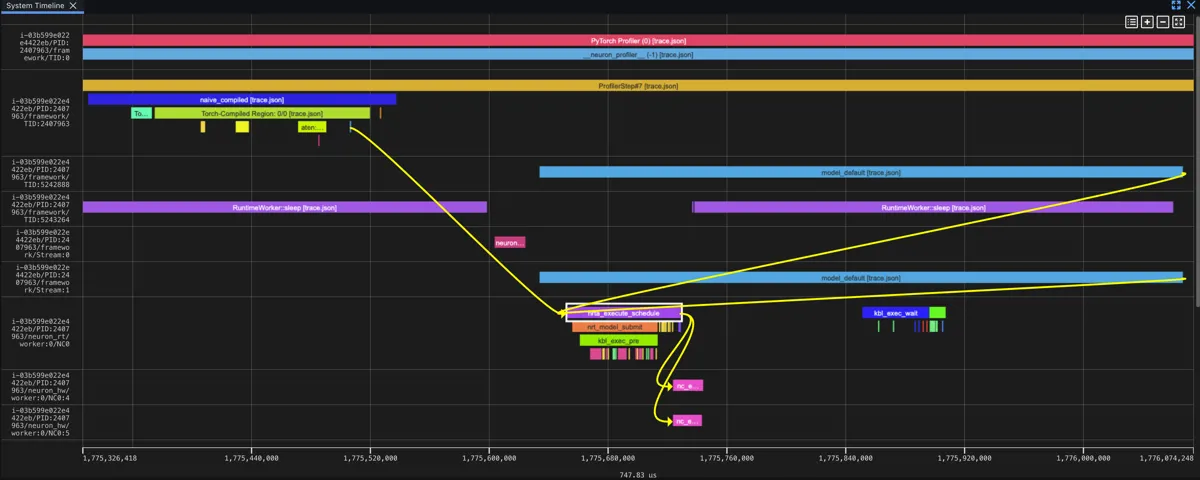
در نمونهٔ آخر، همان تابع خام RMSNorm را با torch.compile و بکاند neuron کامپایل میکنیم. TorchDynamo بایتکد پایتون را بهصورت گراف FX میگیرد و AOTAutograd آن را به عملگرهای ATen پایین میآورد. اینجا بکاند Neuron کل گراف را یکجا دریافت میکند، نه هر عملگر را جداگانه؛ در نتیجه عملیات را ادغام میکند، دسترسی به حافظه را بهینه میکند و گراف را در یک فایل NEFF میسازد که با یک ارسال سختافزاری اجرا میشود.
| نام | تعداد فراخوانی | زمان CPU | زمان دستگاه Neuron | سهم از زمان دستگاه |
|---|---|---|---|---|
| Torch-Compiled Region: 0/0 | 1 | 98.4 میکروثانیه | 375.5 میکروثانیه | 100% |
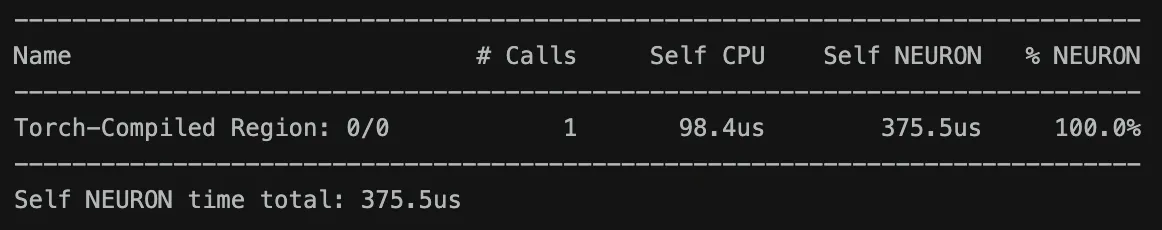
جدول یک اجرای دستگاه نشان میدهد، شبیه نمونهٔ دوم، اما مسیر کد متفاوت است. اینجا بهجای فراخوانی یک عملیات ادغامشدهٔ آماده، کامپایلر خودِ ادغام را از تابع پایتون کشف میکند. در این اجرا زمان Neuron با torch.rms_norm قابل مقایسه است: 375 میکروثانیه در برابر 403 میکروثانیه.
مقایسهٔ کنار هم
| نسخه | زمان دستگاه Neuron | زمان CPU | تعداد فراخوانی عملگر |
|---|---|---|---|
| عملیات خام | 2,355 میکروثانیه | حدود 125 میکروثانیه | 6 |
| torch.rms_norm | 403 میکروثانیه | حدود 48 میکروثانیه | 1 |
| خام بههمراه torch.compile | 376 میکروثانیه | حدود 98 میکروثانیه | 1 |
هر دو روش، یعنی torch.rms_norm و torch.compile، محاسبه را در یک ارسال هسته ادغام میکنند. در این اجراها هر کدام حدود یکششم زمان دستگاهِ پیادهسازی خام را میگیرند. ادغام، فاصلههای میان اجراهای سختافزاری را حذف میکند و جلوی ساختهشدن مقادیر میانی مثل x_sq و mean_sq بین عملگرهای جداگانه را میگیرد.
جمعبندی و قدم بعدی
تابع key_averages() نشان میدهد کدام عملگرها زمان دستگاه را میبلعند و خروجی کاملش آمادهسازی و انتقالهای سمت CPU را هم آشکار میکند. Neuron Explorer همان تصویر را بهصورت بصری در اختیار میگذارد تا یک عملگر را از ارسال فریمورک تا زمانبندی رانتایم و اجرا روی سختافزار دنبال کنید و فاصلههایی را ببینید که ادغام حذفشان میکند.
همین روند روی مدلهای بزرگتر هم جواب میدهد: نقطهٔ داغ را در جدول پیدا کنید، آن را در رد تأیید کنید و بعد ببینید آیا یک عملیات ادغامشده یا torch.compile میتواند هزینهاش را کم کند. اگر روی شتابدهندههای دیگر کار میکنید، نوشتهٔ TorchTPU و اجرای بومی پایتورچ روی تراشههای TPU گوگل هم مسیر مشابهی را نشان میدهد.
در بخش دوم این مجموعه، پروفایل سطح دستگاه بررسی میشود: باز کردن NEFF، نگاه به تفکیک TensorEngine، VectorEngine و دسترسی مستقیم به حافظه (DMA)، و قرار دادن هسته روی خط روفلاین برای تشخیص اینکه محاسبهمحور است یا حافظهمحور.
پرسشهای متداول
چرا ستون زمان دستگاه در جدول پروفایل خالی میماند؟
اگر داخل حلقهٔ پروفایل torch.neuron.synchronize() را صدا نزنید، ممکن است پروفایلر پیش از پایان کار دستگاه خروجی بگیرد و ستون زمان Neuron خالی بماند.
تفاوت پروفایل سیستم و پروفایل فقط دستگاه چیست؟
برای پروفایل سیستم یا ترکیبی، کل پوشهٔ خروجی را در Neuron Explorer بارگذاری میکنید؛ برای پروفایل فقط دستگاه باید فایلهای همنام .neff و .ntff را جداگانه آپلود کنید.
آیا torch.compile بهاندازهٔ torch.rms_norm سریع است؟
در این اجرا زمان دستگاه برای torch.compile حدود 376 میکروثانیه و برای torch.rms_norm حدود 403 میکروثانیه بود؛ هر دو حدود یکششم پیادهسازی خام زمان میبرند.
منبع: Hugging Face



