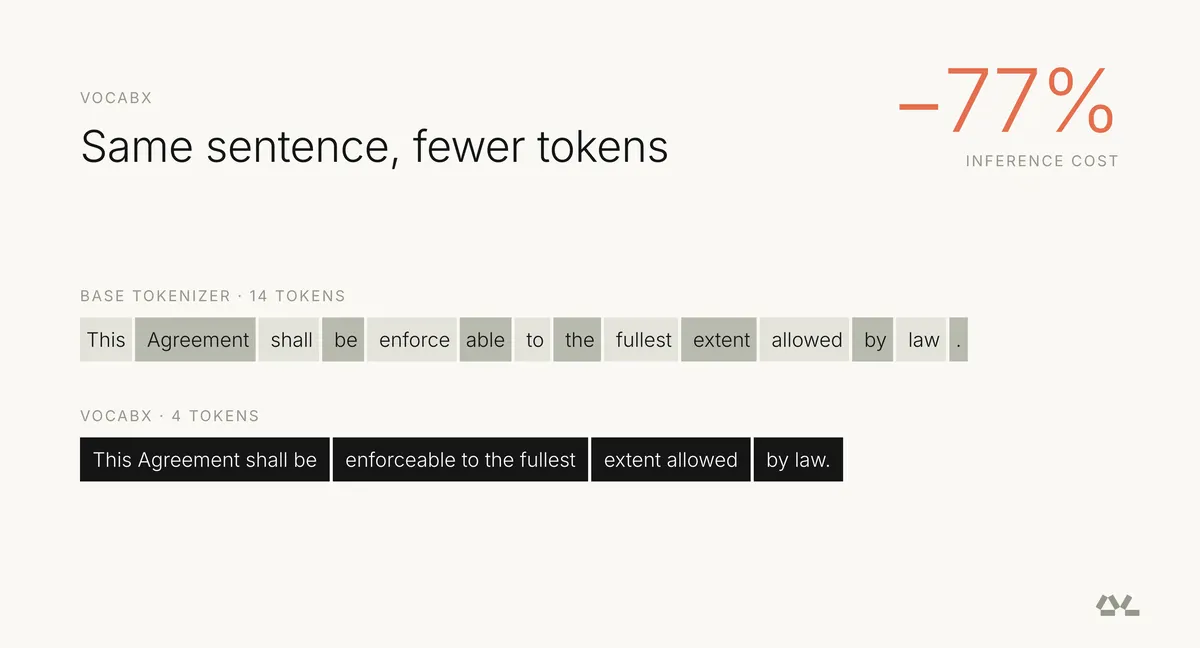
«کاهش هزینه استنتاج» در مدلهای کوچک اغلب به تغییر وزنها یا فشردهسازی مدل گره میخورد. اما وکبایکس (VocabX) نشان میدهد میتوان از یک لایه پایینتر شروع کرد: واژگان. در یک تصحیحکننده واقعی مقاله، این روش هزینه اندازهگیریشده را ۷۷.۰٪ پایین آورد، بدون اینکه مدل پایه عوض شود.
واژگانی که برای همه حوزهها ساخته شده است
یکی از سیستمهایی که تیم سازنده در محیط عملیاتی اجرا میکند، یک تصحیحکننده خودکار مقاله پرتغالی است که بر پایه کوئن۳-۴بی (Qwen3-4B) ساخته شده است. این سیستم مقاله، صورت سؤال و متنهای پشتیبان را میگیرد و یک ارزیابی جیسون (JSON) با نمره و توضیح برای هر مهارت برمیگرداند.
مدل از قبل کوچک بود: ۴ میلیارد پارامتر. برای همین کار هم آموزش دیده بود. اما توکنایزر آن همچنان همان توکنایزر اصلی Qwen3-4B بود؛ ابزاری که برای چند زبان و انواع مختلف متن ساخته شده است. در این تصحیحکننده، از آن فقط برای یک زبان و یک قالب پاسخ استفاده میشد.
این وضعیت دو نوع اتلاف ایجاد میکند. اول، تکهتکه شدن: توکنایزر دقیقاً همان بخشهایی را به قطعات زیادی میشکند که حوزه بیش از همه تکرار میکند؛ مثل پاکت ثابت JSON، نام مهارتها و عبارتهای ارزیابی. دوم، اضافهبار: واژگان دهها هزار ورودی دارد که این حوزه تقریباً هیچوقت به کار نمیبرد، اما مدل هنگام تولید هر توکن برای همه آنها امتیاز محاسبه میکند.
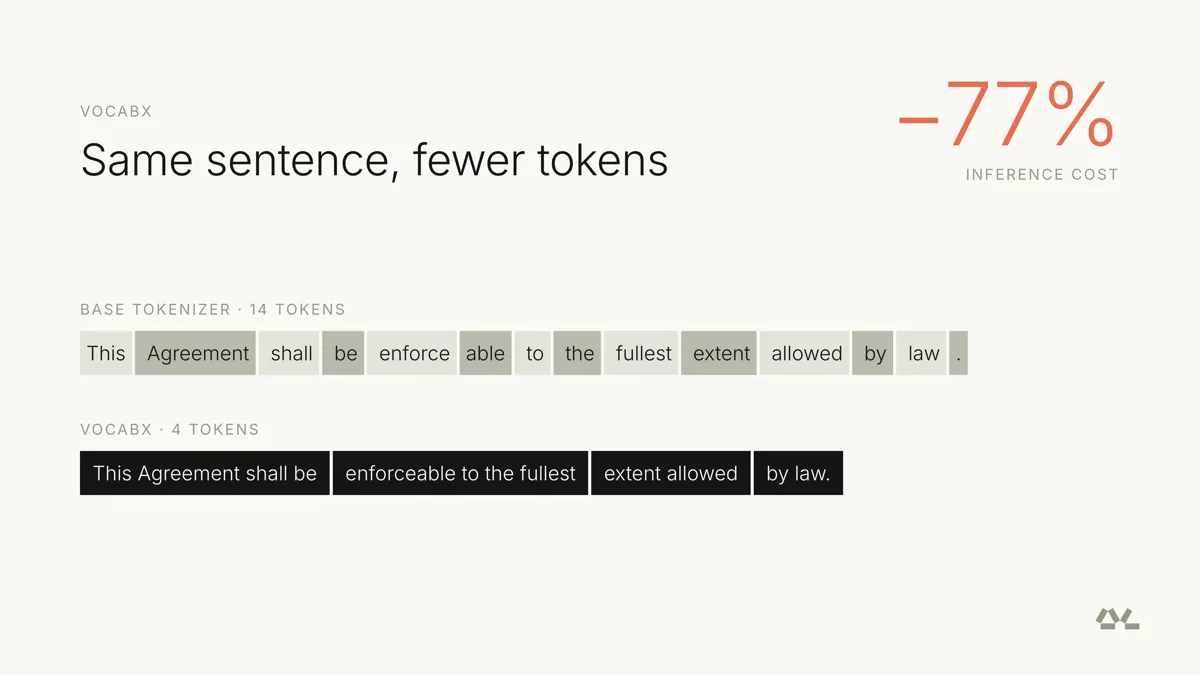
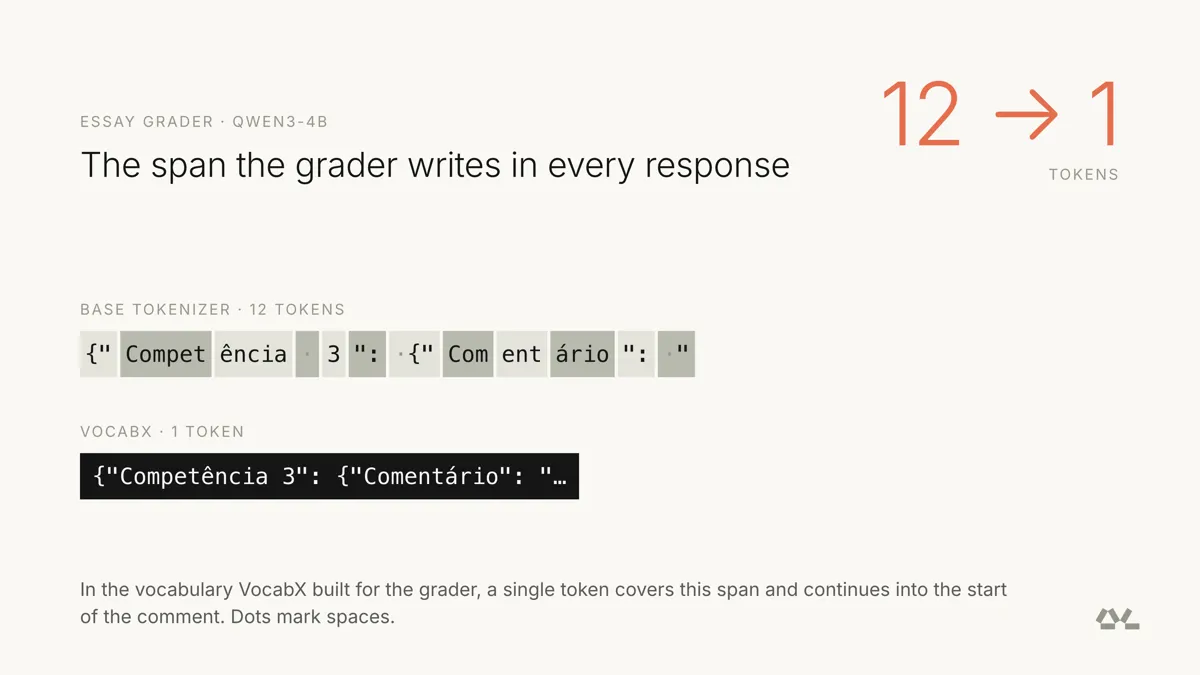
در یک مثال، همان جمله با توکنایزر پایه ۱۴ توکن میشد و با VocabX فقط ۴ توکن. بخشی از پاسخ هم که در هر درخواست تکرار میشود، از ۱۲ توکن به ۱ توکن رسید.
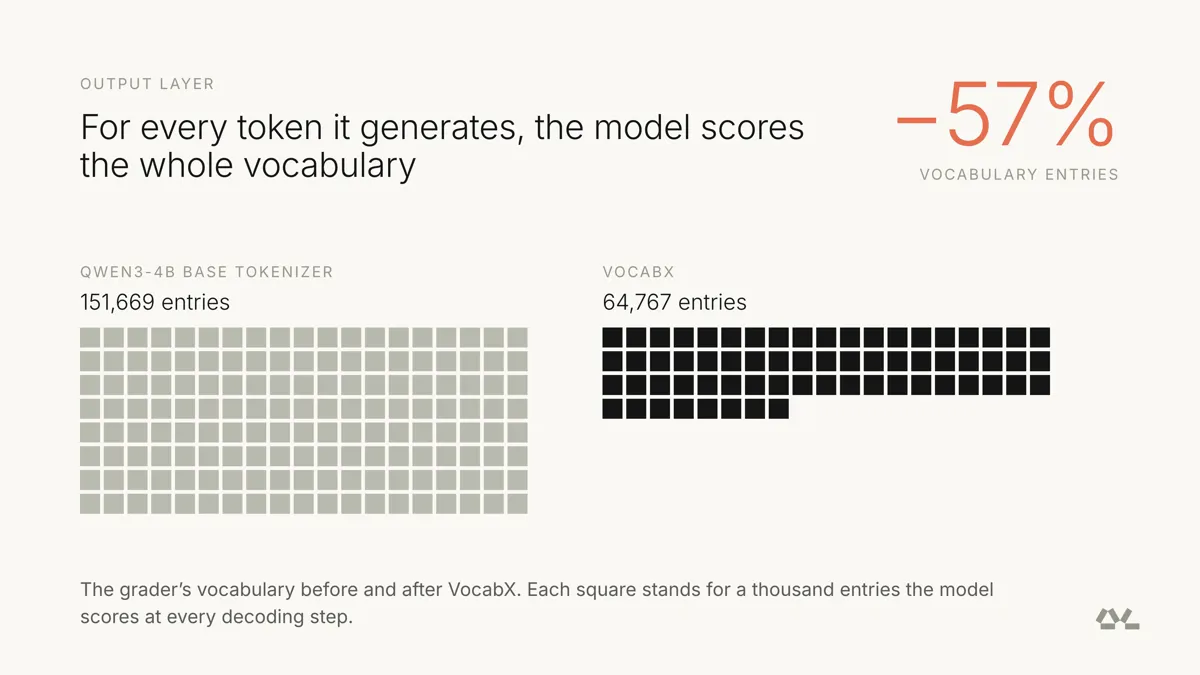
توکنایزر پایه ۱۵۱٬۶۶۹ ورودی داشت. پس از بازسازی واژگان با VocabX، این عدد به ۶۴٬۷۶۷ رسید.
چرا نوشتن گرانتر از خواندن است
واکنش طبیعی به این وضعیت، شمردن توکنها و کمکردن تعداد آنهاست. اما صورتحساب فقط به تعداد توکن بستگی ندارد. در استنتاج، دو فاز وجود دارد: در پیشپُرکردن (prefill)، مدل کل ورودی را یکجا پردازش میکند و هر وزن خواندهشده از حافظه گرافیکی برای همه توکنهای ورودی دوباره استفاده میشود؛ اینجا محدودیت اصلی توان محاسباتی است.
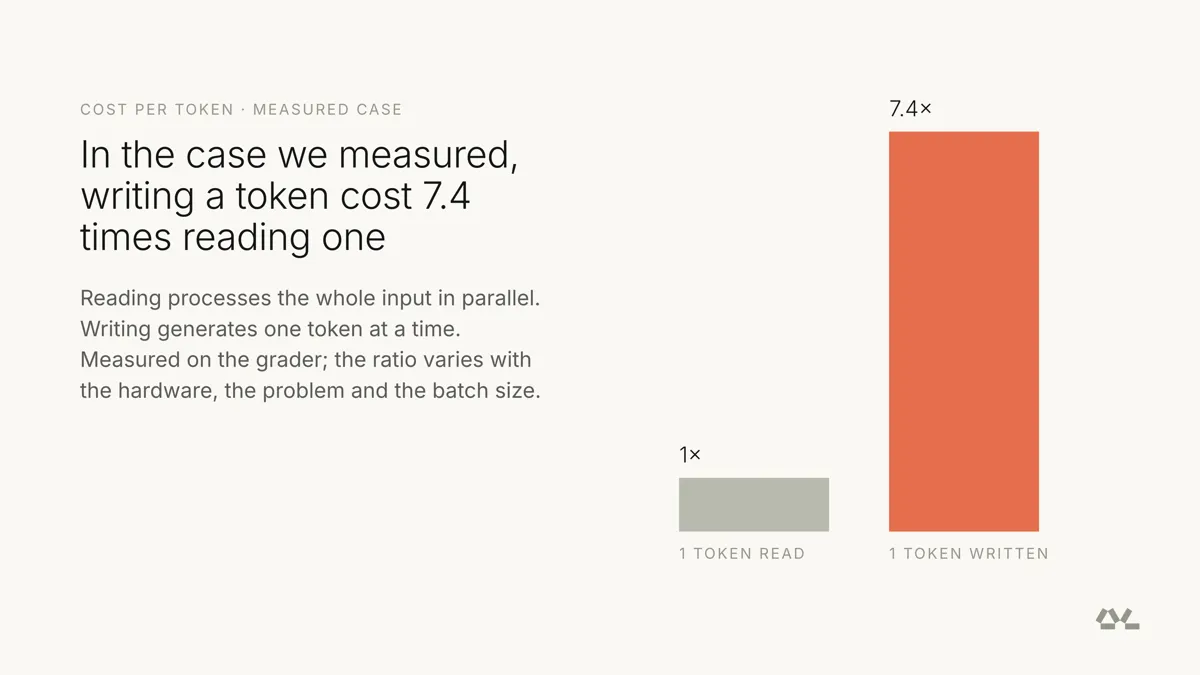
در فاز تولید (decode)، مدل پاسخ را توکنبهتوکن میسازد و هر توکن یک گذر کامل میخواهد. هر خواندن وزن فقط چند بار استفاده میشود و واحد پردازش گرافیکی (GPU) بیشتر وقت خود را منتظر رسیدن داده از حافظه میماند؛ اینجا محدودیت اصلی پهنای باند حافظه است. در تصحیحکنندهای که اندازهگیری شد، تولید یک توکن ۷.۴ برابر خواندن یک توکن هزینه داشت. این نسبت به سختافزار، مسئله، اندازه دسته، طول زمینه و عوامل دیگر بستگی دارد و میتواند بیشتر هم باشد.
مؤلفه سوم صورتحساب، خود واژگان است. لایه آخر مدل، یا سر خروجی (LM head)، برای هر توکن ممکن یک ردیف پارامتر دارد و برای تولید هر توکن کل این ماتریس را میخواند و ضرب میکند. در مدلی به اندازه Qwen3-4B، این ماتریس تقریباً ۱۰٪ پارامترها را میسازد؛ سهمی که مدلهای بزرگ آن را کمتر حس میکنند، اما برای مدل کوچک وزن دارد. در تصحیحکننده، لایه خروجی از حدود ۱۵۲٬۰۰۰ ردیف به حدود ۶۵٬۰۰۰ ردیف رسید.
VocabX چه کاری متفاوت میکند
تغییر واژگان ایده تازهای نیست. روشهای مرجع مثل انتقال سریع واژگان (FVT)، توکنسازی چندکلمهای (MWT) و گسترش درجای توکنایزر (in-place BPE) هم تکهتکه شدن را کم میکنند. اما در آزمون این مسئله، دو محدودیت داشتند: توکنها را بر اساس بسامد انتخاب میکردند، نه هزینه؛ و معمولاً فقط یک لایه را تغییر میدادند.
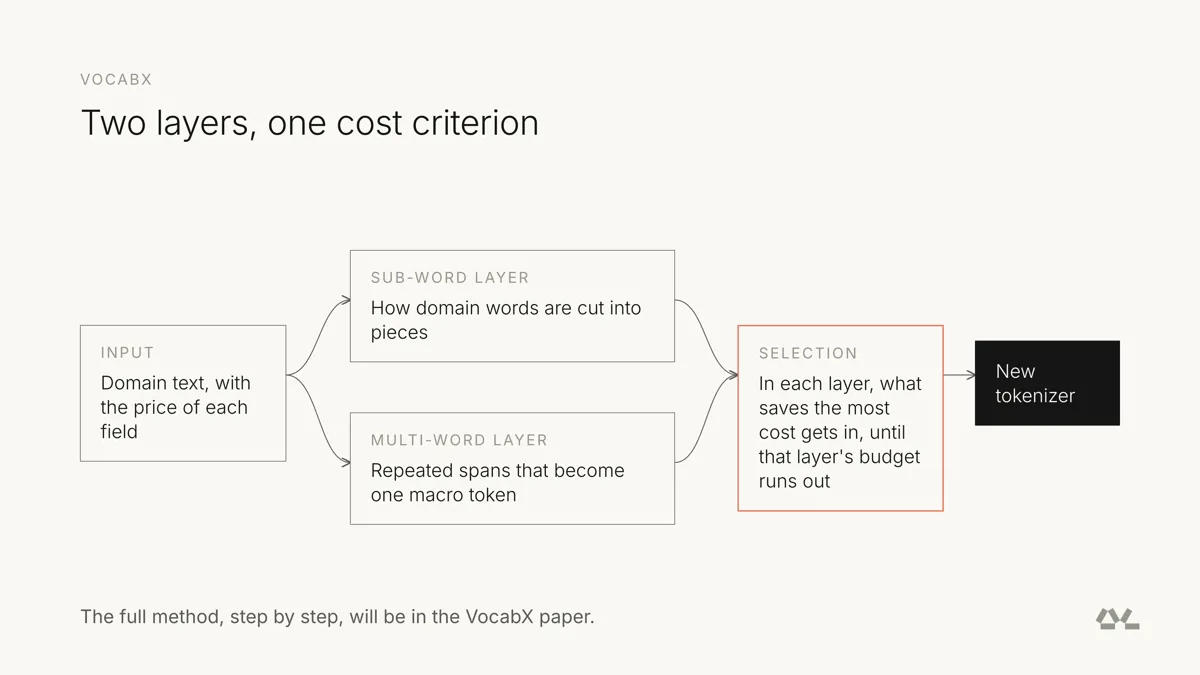
VocabX هر دو محدودیت را کنار میگذارد. بهجای پرسش «این کاندید چند توکن صرفهجویی میکند؟»، میپرسد «چه مقدار هزینه و زمان صرفهجویی میکند؟» هر توکن حذفشده در هر فیلد، با قیمت همان فیلد وزن میخورد: اعلان سیستم، پیام کاربر یا پاسخ مدل. در مورد اندازهگیریشده، یک توکن صرفهجوییشده در پاسخ ۷.۴ برابر یک توکن صرفهجوییشده در ورودی ارزش داشت.
در لایه زیرکلمه، VocabX نحوه تکهتکهشدن واژههای حوزه را از نو میسازد. در لایه چندکلمهای، بازههای تکراری را پیدا میکند؛ از عبارتهای کوتاه تا خطهای کامل و پاکتهای JSON. هر بازه به یک توکن واحد تبدیل میشود که «ماکروتوکن» نام دارد. هر دو لایه با یک معیار هزینه و هرکدام با بودجه خودش انتخاب میشوند.
برای پیدا کردن این بازهها، پنج جستوجوگر خودکار به کار میرود: واژههای بلند، خطهای کامل، عبارتها، جملههای کامل و ساختارهای دارای نشانهگذاری مثل JSON و تگها. میانگینگیری روی هشت پیکره نشان داد جستوجوگر ساختارها بیشترین سهم را دارد و روی کد، بهتنهایی ۱۷.۵ واحد اثر میگذارد. بدون هر پنج جستوجوگر، کاهش توکن روی تصحیحکننده ۵۵.۶ واحد پایین میآمد.
نمونهای که همه چیز را نمیبیند
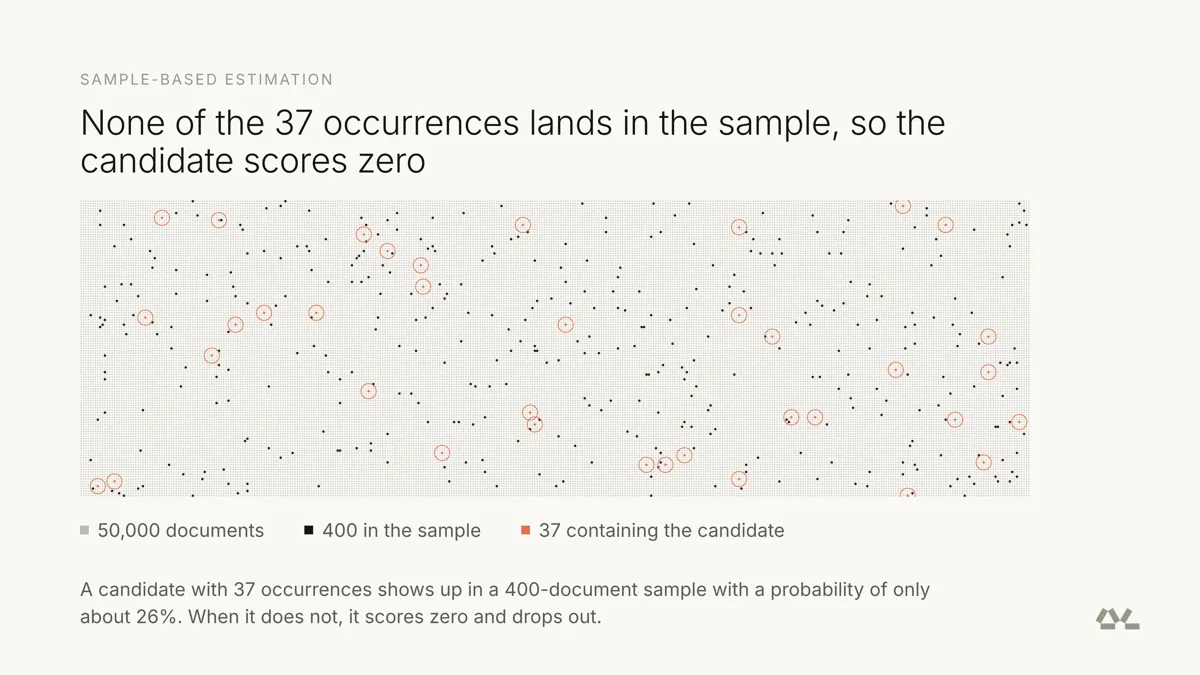
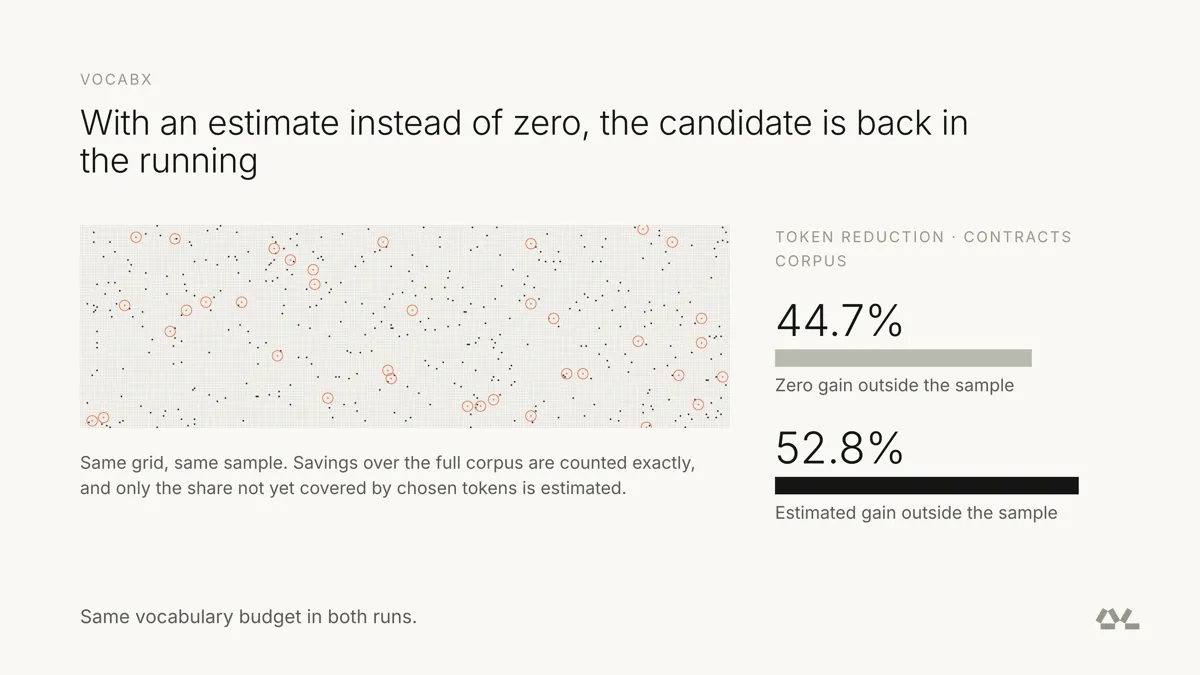
انتخاب توکن بر اساس هزینه نیاز دارد بدانیم هر کاندید پس از انتخابهای قبلی چقدر صرفهجویی باقیمانده دارد. اندازهگیری دقیق این مقدار یعنی پردازش دوباره کل پیکره پس از هر انتخاب؛ کاری که دهها هزار بار تکرار میشود. راه رایج در مقیاس بزرگ، اندازهگیری روی نمونهای از اسناد است. اما در این حالت، کاندیدی که در نمونه نیست صفر گرفته میشود.
مثلاً عبارتی که ۳۷ بار در ۵۰٬۰۰۰ سند ظاهر میشود، فقط حدود ۲۶٪ مواقع در یک نمونه ۴۰۰ سندی دیده میشود. در پیکره قراردادها، تنها ۱۶.۶٪ کاندیدها در نمونه ۴۰۰ سندی حاضر بودند و بقیه هرگز ارزیابی نمیشدند.
VocabX این را جبران میکند. بخشی از سود یک کاندید را میتوان بدون نمونه و دقیق شمرد: مقدار صرفهجویی در کل پیکره. بخش دیگر، یعنی صرفهجوییای که هنوز با توکنهای انتخابشده پوشش داده نشده، نیاز به برآورد دارد. برای کاندیدهایی که نمونه نمیبیند، بهجای صفر از یک برآورد آماری بر پایه رفتار کاندیدهای دیدهشده استفاده میشود. همین تغییر، با همان نمونه و همان بودجه، کاهش توکن روی پیکره قراردادها را از ۴۴.۷٪ به ۵۲.۸٪ رساند.
نتیجه در تصحیحکننده مقاله
برای سنجش اثر واقعی، هفت نسخه از تصحیحکننده با مدل پایه، داده، دستور آموزش و بذر یکسان آموزش داده شد. تنها تفاوت آنها توکنایزر بود. همه نسخهها همان ۵۰۰ درخواست را روی همان ماشین آزمون با آرتیایکس ۵۰۹۰ (RTX 5090) و سرور استنتاج ویالالام (vLLM) اجرا کردند و هزینه از زمان اجرای اندازهگیریشده محاسبه شد.
پاسخ مدل بهطور میانگین از ۳۵۰ توکن به ۱۰۱ توکن رسید. هزینه ۷۷.۰٪ کم شد و کیفیت، بر اساس امتیاز بنچ (bench score) که دقت نمرهدهی و دقت جداسازی مقالههای خارج از موضوع یا ناقض قواعد را ترکیب میکند، از ۰.۷۰۳ به ۰.۸۱۰ افزایش یافت.
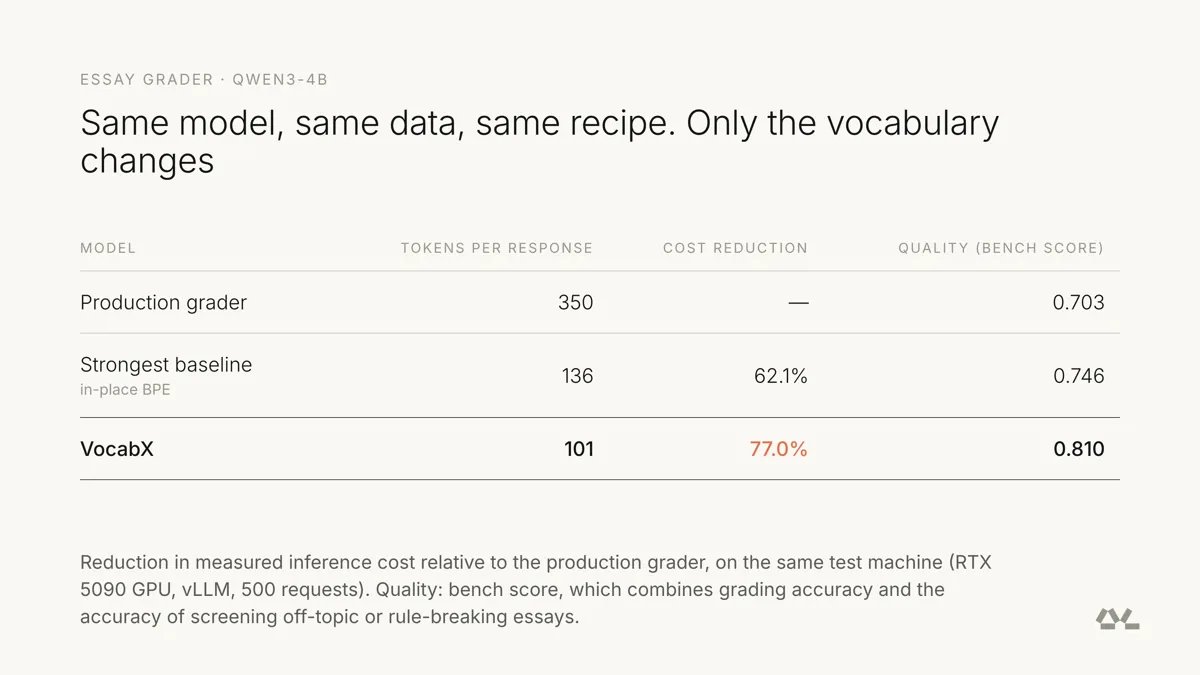
رسیدن به این نتیجه یک اصلاح مسیر هم لازم داشت. نسخه اول واژگان، نمره هر مهارت را با JSON اطرافش در یک ماکروتوکن ادغام میکرد. فشردهترین گزینه بود، اما کیفیت افت کرد: امتیاز بنچ ۰.۶۸۹ شد، پایینتر از ۰.۷۰۳ نسخه عملیاتی. وقتی نمره داخل ماکرو بود، هر ترکیب نمره و ساختار به گونهای از همان توکن تبدیل میشد و مدل هر دو را در یک گام انتخاب میکرد. دادن توکن جداگانه به نمره، ۲ توکن اضافه بر هر پاسخ هزینه داشت، اما امتیاز را به ۰.۸۱۰ رساند و در اندازهگیری حتی ارزانتر بود: ۷۷.۰٪ کاهش در برابر ۷۳.۳٪ نسخه ادغامشده.
درس این بخش فقط به تصحیحکننده محدود نمیشود. فشردهسازی وقتی هزینه دارد که بازه فشردهشده همان تصمیمی را در خود داشته باشد که مدل برای آن ساخته شده است. هدف، ارزانترین واژگان ممکن نیست؛ ارزانترین واژگانی است که توکنهای مهم را حفظ کند.
فراتر از یک تصحیحکننده
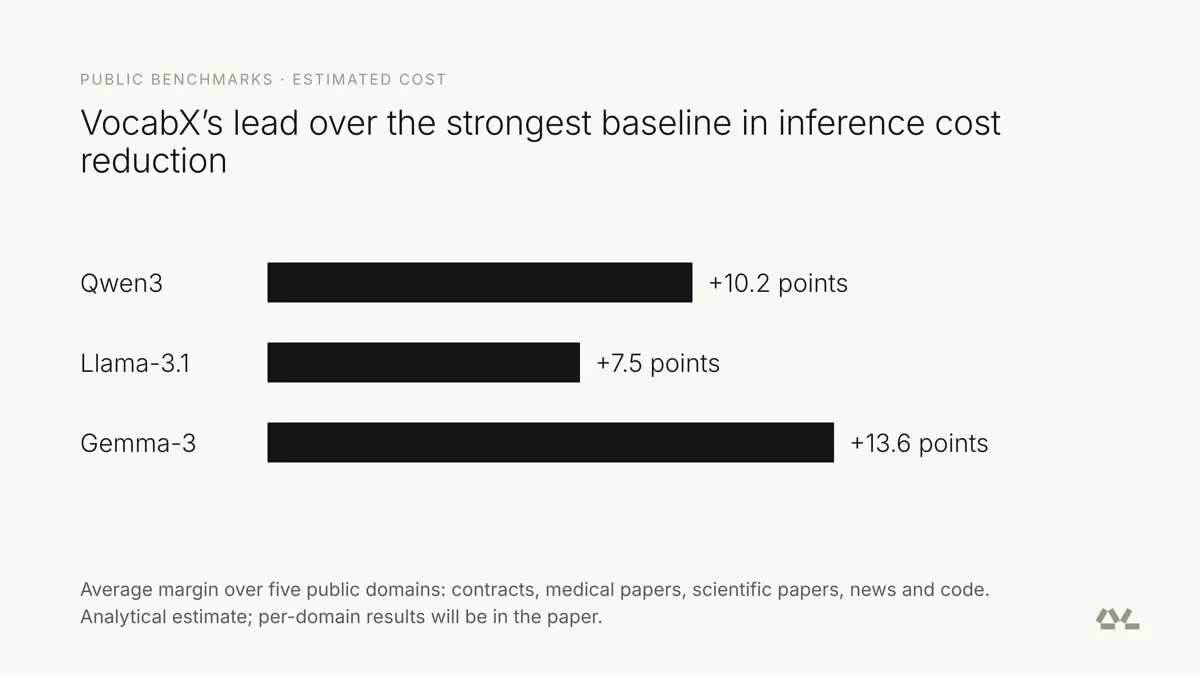
برای اینکه روشن شود این سود فقط مربوط به همین کاربرد است یا نه، VocabX با سه روش مرجع در پنج دامنه عمومی مقایسه شد: قراردادها، مقالههای پزشکی، مقالههای علمی، اخبار و کد پایتون (Python). این آزمون روی سه خانواده مدل انجام شد: Qwen3، لاما-۳.۱ (Llama-3.1) و جما-۳ (Gemma-3). همه روشها همان اسناد معدنکاوی و آزمون و همان سقف واژگان را داشتند.
VocabX در هر ۱۵ ترکیب، بیشتر از قویترین روش مرجع فشرده کرد؛ بین ۱.۲ تا ۹.۳ واحد. در هزینه استنتاج برآوردی هم نسخه هرسشده VocabX در هر ۱۵ ترکیب پیشتاز بود؛ با میانگین برتری ۱۰.۲ واحد روی Qwen3، ۷.۵ واحد روی Llama-3.1 و ۱۳.۶ واحد روی Gemma-3. در قراردادها، نسخه هرسشده به ۶۲.۶٪ کاهش توکن با ۱۱۳٬۴۲۶ ورودی واژگان رسید، در برابر ۶۱.۸٪ بهترین تنظیم in-place BPE که ۲۰۷٬۸۰۳ ورودی داشت.
VocabX مدل را باهوشتر نمیکند. کاری که میکند این است که مدل دیگر بابت متنی که لازم نیست تکهتکه بنویسد، و بابت واژگانی که هرگز به کار نمیبرد، هزینه نپردازد. در تصحیحکننده مورد آزمایش، این کار هزینه استنتاج اندازهگیریشده را ۷۷٪ کم کرد، با همان مدل پای
پرسشهای متداول
VocabX چه فرقی با توکنایزر معمولی دارد؟
VocabX واژگان را بر اساس هزینه هر توکن و نه فقط بسامد انتخاب میکند. این کار را هم در لایه زیرکلمه و هم در لایه چندکلمهای انجام میدهد.
کاهش هزینه ۷۷ درصدی در چه سیستمی اندازهگیری شد؟
در یک تصحیحکننده خودکار مقاله پرتغالی مبتنی بر Qwen3-4B که پاسخ را در قالب JSON مینویسد. هزینه از زمان اجرای واقعی روی RTX 5090 و سرور vLLM محاسبه شد.
کیفیت مدل با VocabX افت کرد؟
در نسخه نهایی، امتیاز بنچ از ۰.۷۰۳ به ۰.۸۱۰ رسید. اما نسخه اول که نمره را داخل ماکروتوکن JSON ادغام کرده بود، امتیاز ۰.۶۸۹ گرفت و کنار گذاشته شد.
آیا VocabX روی مدلهای دیگر هم آزمایش شد؟
بله؛ در ۱۵ ترکیب از پنج دامنه و سه خانواده مدل Qwen3، Llama-3.1 و Gemma-3 بررسی شد. VocabX در همه این ترکیبها بیشتر از قویترین روش مرجع فشردهسازی کرد.
منبع: Hugging Face



