ALTK-Evolve روشی است که از دل تلاشهای خود ایجنت، یک «دفترچه راهنما»ی رفتاری میسازد و آن را به پرامپت سیستمی اضافه میکند؛ نتیجه، رسیدن یک ایجنت پایه با مدل غیراستدلالی جیپیتی-۴.۱ (GPT-4.1) به صدر بنچمارک τ²-bench در خدمات مشتری است، بیآنکه حتی یک وزن مدل بهروزرسانی شود.
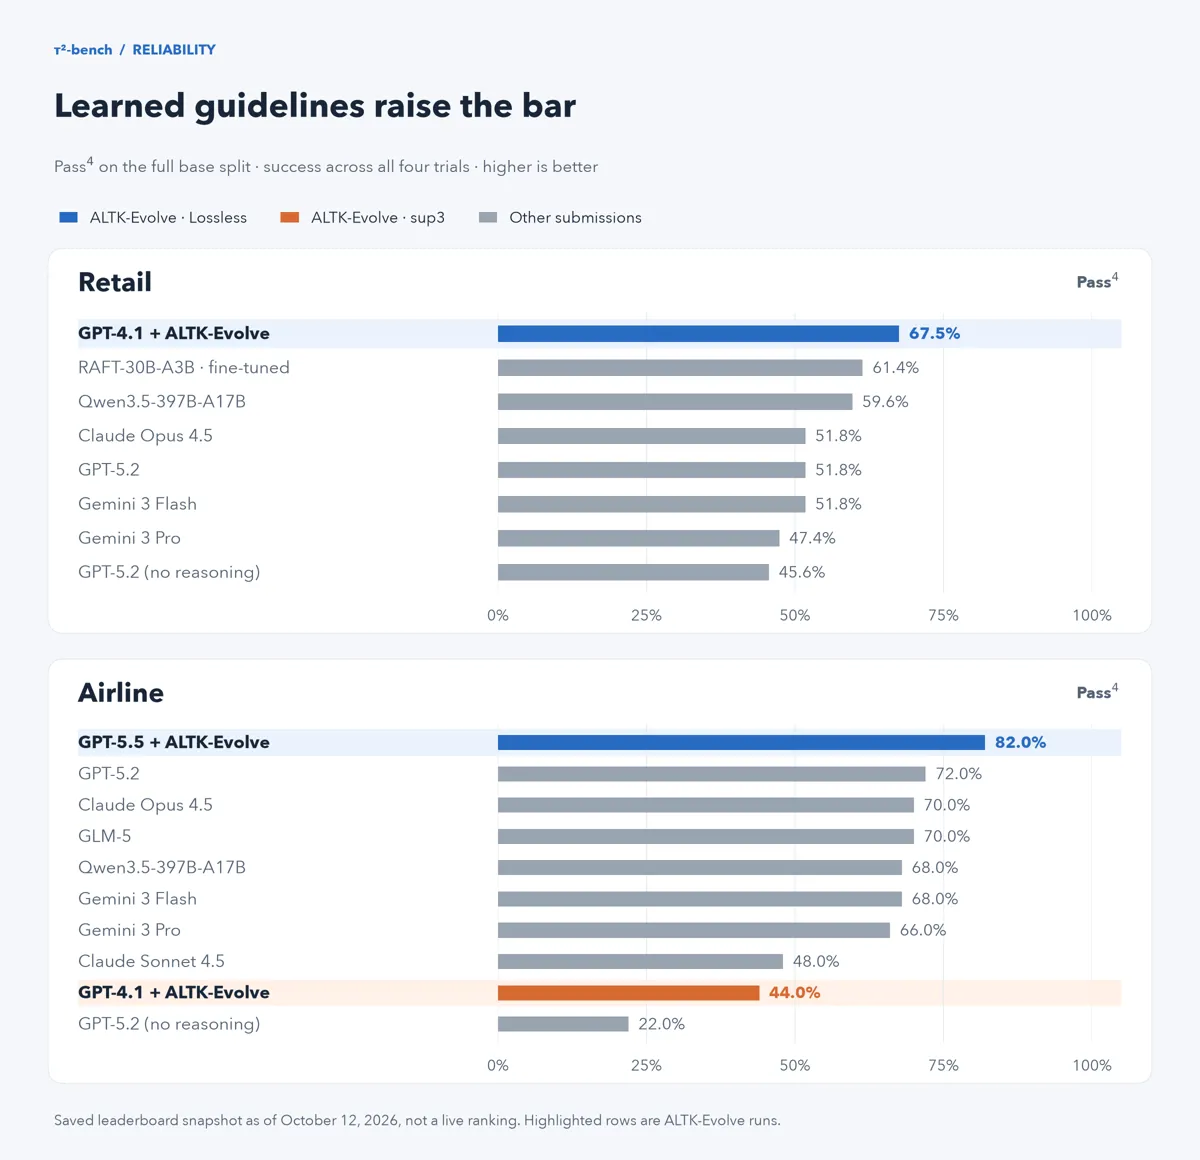
در امتیازدهی بنچمارک τ²-bench، این ایجنت در دامنه خردهفروشی به نرخ Pass^4 برابر ۶۷.۵ درصد میرسد؛ یعنی ۶۷.۵ درصد از وظایف را در هر چهار تلاش مستقل حل میکند. این عدد بالاتر از هر ورودی خردهفروشی در تصویر جدول امتیازات ۱۲ اکتبر ۲۰۲۶ است. همهچیز روی همان اسکافولد ریکت (ReAct) استاندارد بنچمارک اجرا میشود و تنها تغییر، افزودن راهنماهای آموختهشده به انتهای پرامپت سیستمی است.
حافظه آموختهشده چگونه ساخته میشود؟
ALTK-Evolve ابتدا رفتار ایجنت را روی وظیفههای تمرینی بررسی میکند و سپس با همان مدل، موفقیتها و شکستها را به قواعد رفتاری کوتاه تبدیل میکند: نحوه احراز هویت مشتری، تأیید یک تراکنش، یا پردازش یک مرجوعی. این قواعد در گفتگوهای بعدی به پرامپت ایجنت اضافه میشوند.
نکته مهم این است که یک مدل واحد هم راهنماها را استخراج میکند و هم ایجنت را میگرداند؛ نه بهروزرسانی وزنی لازم است و نه برچسبزنی انسانی. نمونهای از این قواعد که بهصورت فهرست مارکداون ساده پس از سند سیاست دامنه قرار میگیرد:
- پیش از هر اقدام مرتبط با سفارش، کاربر را احراز هویت کن؛ اگر ایمیل در دسترس نبود، با نام کامل و کد پستی هویت را بسنج.
- همه تغییرهای موردنظر را با یک خلاصه ساختارمند تأیید کن و پیش از هر اقدامی که پایگاه داده را تغییر میدهد، تأیید صریح کاربر را بخواه.
- در مرجوعی یا تعویض، مبلغ بازگشتی را با ریز اقلام و زمانبندی بازپرداخت توضیح بده، بدون اینکه منتظر پرسش کاربر بمانی.
- در هر گام فقط یک اقدام انجام بده؛ هرگز فراخوانی ابزار و پیام به کاربر را در یک نوبت ترکیب نکن.
- پیش از جستوجوی کاربر، نام را پاکسازی و تفکیک کن و پس از یکی دو جستوجوی ناموفق، قالب دقیق موردنیاز را اعلام کن.
راهنماها از مسیرهای ایجنت روی وظیفههای تمرینی τ²-bench با همان جیپیتی-۴.۱ استخراج و بدون تغییر روی مجموعه آزمون نگهداشتهشده اعمال میشوند. پیش از این هم همین رویکرد روی ایجنتهای کدنویسی آزمایش شده بود.
بنچمارک τ²-bench چه چیزی را میسنجد؟
τ²-bench که سیرا (Sierra) آن را ساخته، توانایی ایجنت در اداره گفتگوهای خدمات مشتری زیر محدودیتهای واقعی را اندازه میگیرد. در هر وظیفه، ایجنت روبهروی مشتری شبیهسازیشدهای با یک مدل زبانی قرار میگیرد که هدف مشخصی دارد؛ مجموعهای از ابزارهای دامنه (بررسی سفارش، صدور بازپرداخت، تغییر پرواز) در اختیار است و یک سند سیاست مکتوب باید رعایت شود.
ایجنت باید جزئیات درست را بیرون بکشد، در چارچوب سیاست بماند و اقدام درست — که اغلب بازگشتناپذیر است — را انجام دهد. پاداش دودویی و سختگیرانه است: وظیفه تنها زمانی حلشده شمرده میشود که وضعیت نهایی پایگاه داده با نتیجه موردانتظار بخواند. دو دامنه خدمات مشتری، خردهفروشی و خطوط هوایی، در این آزمایش به کار رفتهاند.
راهاندازی آزمایش و سه سطح راهنما
پیادهسازی خود بنچمارک از یک ایجنت ریکت پایه با حلقه دو مرحلهای THINK → ACT استفاده میکند؛ مدل ایجنت جیپیتی-۴.۱ و مدل شبیهساز مشتری جیپیتی-۵.۵ است و هر وظیفه چهار بار آزمایش میشود. هر راهنما یک «تعداد پشتیبان» دارد؛ یعنی شمار وظیفههای تمرینی متمایزی که آن قاعده از آنها استخراج شده است. سه پیکربندی مقایسه شدهاند:
| پیکربندی | راهنماهای داخل زمینه | خردهفروشی | خطوط هوایی |
|---|---|---|---|
| baseline | بدون راهنما | ۰ | ۰ |
| sup3 | پشتیبان ≥ ۳ (هسته پرارتکا) | ۳۱ | ۱۴ |
| lossless | همه راهنماها | ۲۹۲ | ۱۰۱ |
هر وظیفه چهار بار تلاش میشود و نتایج از دو زاویه خوانده میشوند: میانگین دقت که محور توانمندی است و میگوید ایجنت چند وقت یکبار کار را درست انجام میدهد، و Pass^4 که محور پایایی است و درصد وظایف حلشده در هر چهار تلاش را نشان میدهد. همین معیار دوم است که جدول امتیازات τ²-bench گزارش میکند؛ چون ایجنت پشتیبانی که از چهار بازپرداخت، سهتا را درست انجام دهد، باز هم یکچهارم مشتریان واقعی را ناکام میگذارد.
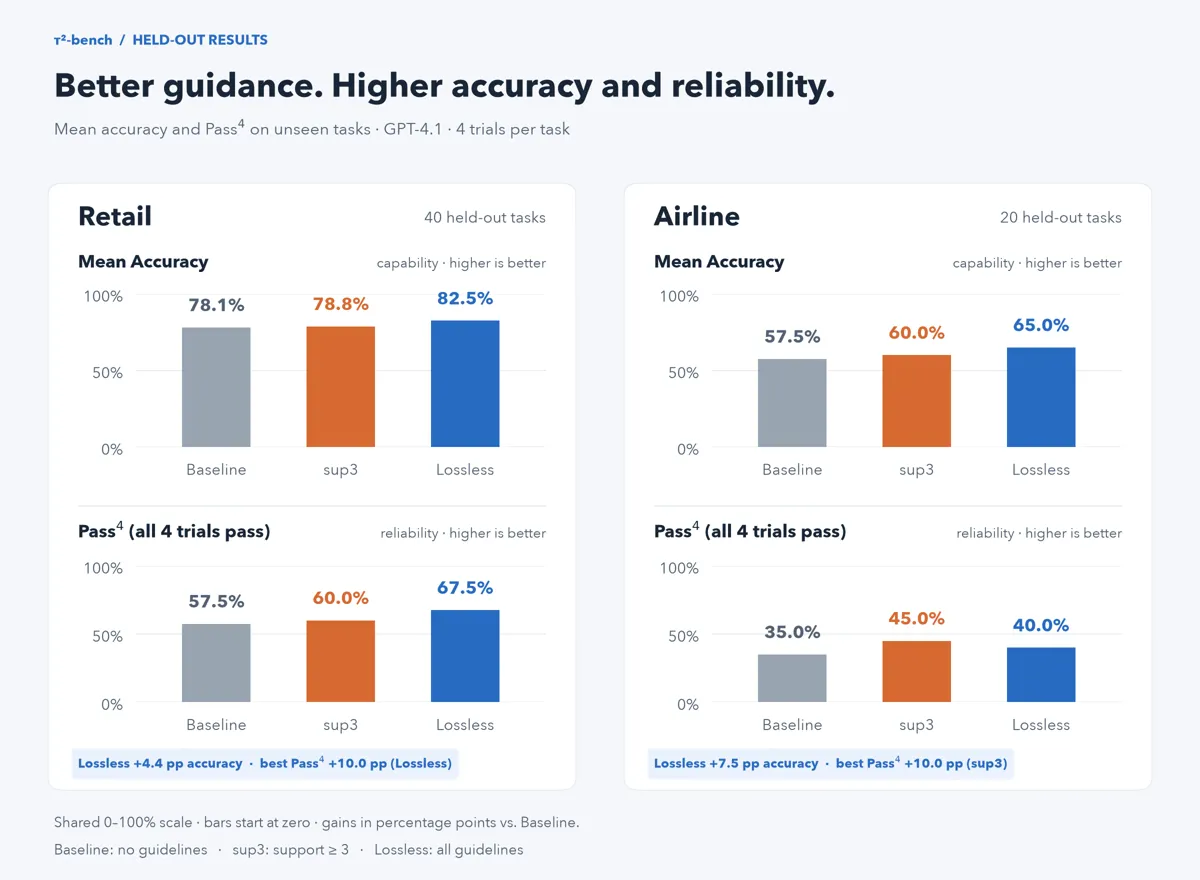
دقت و پایایی، هر دو بالا میروند
| دامنه (وظیفههای آزمون) | پیکربندی | میانگین دقت | Pass^4 |
|---|---|---|---|
| خردهفروشی (۴۰) | baseline | ۷۸.۱٪ | ۵۷.۵٪ |
| sup3 | ۷۸.۸٪ (+۰.۷) | ۶۰.۰٪ (+۲.۵) | |
| lossless | ۸۲.۵٪ (+۴.۴) | ۶۷.۵٪ (+۱۰.۰) | |
| خطوط هوایی (۲۰) | baseline | ۵۷.۵٪ | ۳۵.۰٪ |
| sup3 | ۶۰.۰٪ (+۲.۵) | ۴۵.۰٪ (+۱۰.۰) | |
| lossless | ۶۵.۰٪ (+۷.۵) | ۴۰.۰٪ (+۵.۰) |
میانگین دقت در هر دو دامنه بالا میرود: خردهفروشی ۴.۴ واحد (از ۷۸.۱ به ۸۲.۵) و خطوط هوایی ۷.۵ واحد (از ۵۷.۵ به ۶۵.۰). پایایی جلوتر هم میرود؛ Pass^4 در خردهفروشی ۱۰ واحد (از ۵۷.۵ به ۶۷.۵) و در خطوط هوایی ۱۰ واحد (از ۳۵.۰ به ۴۵.۰) رشد میکند. این بهبودها از تصمیمگیری بهتر میآید، نه از گفتگوی طولانیتر.
مقدار درست راهنمایی به دامنه بستگی دارد
این دو دامنه درباره «چقدر راهنمایی کافی است» با هم اختلاف دارند. در خردهفروشی، بیشتر بهتر است: هسته کوچک sup3 بهسختی از حالت پایه در دقت جلو میزند و برای جهش واقعی به مجموعه کامل lossless نیاز است. در خطوط هوایی تصویر در سر پایایی برعکس میشود: lossless در دقت جلوتر است (۶۵٪ در برابر ۶۰٪)، اما هسته جمعوجور sup3 با ۱۴ راهنما پایاتر است و Pass^4 را به ۴۵٪ میرساند در برابر ۴۰٪ برای lossless. تعداد پشتیبان یک پیچ قابل تنظیم برای هر دامنه است، نه عددی که یکبار برای همیشه ثابت شود.
هزینه: توکن بیشتر، نه نوبت بیشتر
راهنماها رایگان نیستند، اما هزینه در همان جایی مینشیند که انتظار میرود: توکنهای ورودی پرامپت، نه در گفتگویی طولانیتر و پرگشتتر.
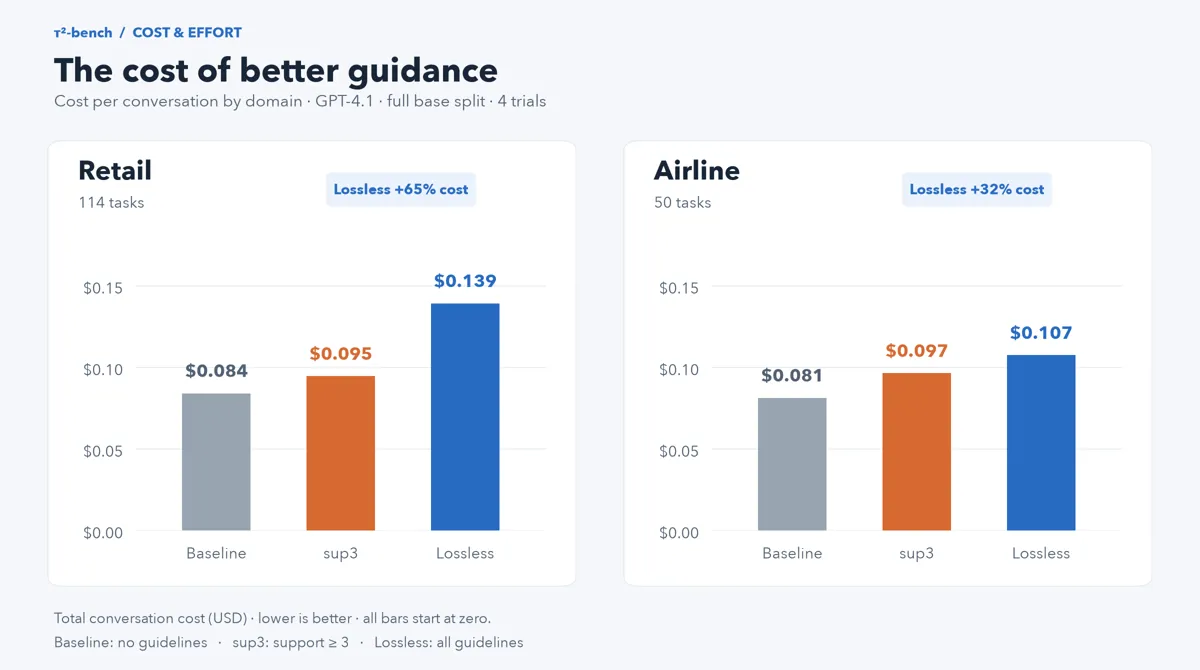
| دامنه | پیکربندی | هزینه هر گفتگو | نسبت به پایه |
|---|---|---|---|
| خردهفروشی | baseline | ۰.۰۸۴ دلار | — |
| sup3 | ۰.۰۹۵ دلار | +۱۲٪ | |
| lossless | ۰.۱۳۹ دلار | +۶۵٪ | |
| خطوط هوایی | baseline | ۰.۰۸۱ دلار | — |
| sup3 | ۰.۰۹۷ دلار | +۱۹٪ | |
| lossless | ۰.۱۰۷ دلار | +۳۲٪ |
برای پاسخ به این پرسش که «آیا ایجنت با حرفزدن بیشتر به نتیجه میرسد؟»، اجراهای یکسان مقایسه شدهاند؛ یعنی وظایفی که هم در حالت پایه و هم با راهنما حل شدهاند، با سناریو و seed یکسان. شمار نوبتهای دستیار نشان میدهد گفتگو کوتاهتر هم میشود: در خردهفروشی lossless از ۱۰.۵۹ به ۱۰.۱۶ نوبت و در خطوط هوایی از ۹.۱۵ به ۸.۸۲ نوبت میرسد، و هیچ پیکربندی گفتگو را طولانیتر نمیکند.
| دامنه | مجموعه مشترک | حلشده در هر دو (n) | نوبت پایه | با راهنما | تفاوت |
|---|---|---|---|---|---|
| خردهفروشی | baseline ∩ sup3 | ۱۰۸ | ۱۰.۴۰ | ۱۰.۳۵ | −۰.۰۵ |
| baseline ∩ lossless | ۱۱۱ | ۱۰.۵۹ | ۱۰.۱۶ | −۰.۴۳ | |
| خطوط هوایی | baseline ∩ sup3 | ۳۸ | ۸.۹۷ | ۸.۵۳ | −۰.۴۵ |
| baseline ∩ lossless | ۴۰ | ۹.۱۵ | ۸.۸۲ | −۰.۳۳ |
این موضوع از بحث هزینه فراتر میرود: هر نوبت یک رفتوبرگشت ترتیبی با مدل زبانی است، پس نوبت کمتر یعنی تأخیر سرتاسری کمتر و زمان تکمیل کوتاهتر برای مشتری. تنها بهای واقعی، سمت ورودی است؛ پرامپت سیستمی بزرگتر که روی هر فراخوانی سوار میشود. پرامپت ۲۹۲ راهنمایی خردهفروشی هزینه هر گفتگو را از حدود ۰.۰۸۴ به ۰.۱۳۹ دلار میرساند، در حالی که دفترچه کوچکتر خطوط هوایی ارزانتر تمام میشود. در تولید، حتی همین هزینه هم با کشکردن پرامپت تا حد زیادی بازیافت میشود، چون بلوک راهنماها در همه فراخوانیها یکسان است.
با مدلهای مرزی هم جواب میدهد
تا اینجا آزمایش با مدلی قدیمی و غیراستدلالی انجام شده بود. اما این ایراد قابل تصور است که راهنماهای آموختهشده شاید فقط شکافهای یک مدل ضعیفتر را پر کنند. برای بررسی مستقیم، دامنه خطوط هوایی با جیپیتی-۵.۵ برای ایجنت و استخراج راهنما، روی همان اسکافولد ریکت، دوباره اجرا شد و راهنماها از اجراهای خود ایجنت بازاستخراج شدند. یک جزئیات با تغییر مدل عوض میشود: هیچ راهنمایی در این تنظیم به پشتیبان ۳ نرسید (حداکثر ۲)، بنابراین هسته پرارتکا اینجا sup2 است، نه sup3.
| خطوط هوایی · جیپیتی-۵.۵ (۲۰ وظیفه آزمون) | دقت | Pass^4 |
|---|---|---|
| baseline (بدون راهنما) | ۷۲.۵٪ | ۵۵.۰٪ |
| sup2 (۱۰۳ راهنما) | ۸۰.۰٪ (+۷.۵) | ۷۰.۰٪ (+۱۵.۰) |
| lossless (۱۴۶ راهنما) | ۸۲.۵٪ (+۱۰.۰) | ۷۰.۰٪ (+۱۵.۰) |
راهنماها این تنظیم را هم بهتر میکنند: افزودن آنها به پرامپت، دقت را ۱۰ واحد (از ۷۲.۵ به ۸۲.۵) و Pass^4 را ۱۵ واحد (از ۵۵.۰ به ۷۰.۰) بالا میبرد؛ بهبود پایایی بزرگتر از آنچه با جیپیتی-۴.۱ روی همین وظیفهها دیده شد (+۱۰ واحد) و شروع از کف بالاتر. علاوه بر این، جایی که پایایی حالت پایه میان اجراهای تکراری نوسان داشت، پیکربندی lossless دقیقاً بازتولید شد.
صدر جدول امتیازات
ارسالها برای جدول τ²-bench روی تقسیم کامل base (تمرین ∪ آزمون) امتیازدهی و با Pass^4 گزارش میشوند؛ چون این تقسیم کل مجموعه وظایف را پوشش میدهد، این اعداد با اعداد مجموعه آزمون نگهداشتهشده که بالاتر آمد، متفاوتاند. اینجا همانجایی است که نتیجه عملی خودش را نشان میدهد؛ حافظهای که فقط در سطح پرامپت زندگی میکند، ایجنت هر مدل پایه را به محدوده مدلهای مرزی میرساند یا از آن عبور میدهد:
- خردهفروشی: رتبه یک. ایجنت با راهنماهای آموختهشده روی تقسیم کامل به Pass^4 = ۶۷.۵٪ میرسد، جلوتر از هر مدل مرزی و جلوتر از رَفت-۳۰بی-ای۳بی (RAFT-30B-A3B) با ۶۱.۴٪ که روی داده مصنوعی خردهفروشی τ²-bench فاینتیون شده است. با جیپیتی-۴.۱ استاندارد و یک دفترچه راهنمای افزودهشده به پرامپت، ۶.۱ واحد از آن سامانه فاینتیونشده جلوتر میافتد.
- خطوط هوایی: رتبه یک با جیپیتی-۵.۵ و رتبه هشت با جیپیتی-۴.۱. هسته جمعوجور sup3 به ایجنت با جیپیتی-۴.۱ نرخ Pass^4 = ۴۴٪ میدهد؛ رتبه هشتم، جلوتر از جیپیتی-۵.۲ بدون استدلال و نزدیک به کلود سانت ۴.۵. با مدل پایه قویتر، همین رویکرد صدر میدان را میگیرد: ایجنت با جیپیتی-۵.۵ به ۸۲.۰٪ میرسد و از هر ورودی مرزی (۶۶ تا ۷۲ درصد) عبور میکند.
ایجنتها میتوانند بدون بهروزرسانی وزن بهتر شوند
فاینتیون یک مدل روی یک بنچمارک گران و شکننده است و به دامنه بعدی منتقل نمیشود. در اینجا ALTK-Evolve یک ایجنت استاندارد روی یک مدل استاندارد را در هر دو دامنه بهتر میکند و در خردهفروشی به یک سامانه فاینتیونشده میرسد یا از آن جلو میزند؛ تنها با راهنماهایی در سطح پرامپت که بهصورت خودکار از اجراهای خود ایجنت استخراج شدهاند، بدون برچسبزنی انسانی و بدون هیچ نشت از مجموعه آزمون.
اگر میخواهید بدانید چرا پایایی ایجنتها اینقدر مهم است، مطلب چرا دستیار هوش مصنوعی شما گاهی موفق میشود و گاهی نه؟ را ببینید. برای معنای زمینهای درست در دستیارها هم RAG چیست و چرا دستیار شما باید فقط از اسناد خودتان جواب بدهد؟ توضیح میدهد و چه زمانی گفتگو را از هوش مصنوعی تحویل بگیریم؟ به مرز میان ایجنت و اپراتور انسانی میپردازد.
پرسشهای متداول
ALTK-Evolve چیست؟
روشی که تلاشهای ایجنت روی وظیفههای تمرینی را تحلیل میکند و موفقیتها و شکستها را به قواعد رفتاری کوتاه تبدیل میکند؛ این قواعد به پرامپت سیستمی ایجنت اضافه میشوند، بدون بهروزرسانی وزن مدل یا برچسبزنی انسانی.
معیار Pass^4 چه چیزی را میسنجد؟
درصد وظایفی که ایجنت در هر چهار تلاش مستقل حل میکند. این معیار پایایی را میسنجد و همان چیزی است که جدول امتیازات τ²-bench گزارش میکند.
آیا راهنماهای آموختهشده هزینه را بالا میبرند؟
بله، هزینه هر گفتگو در خردهفروشی ۶۵ درصد و در خطوط هوایی ۳۲ درصد بیشتر از حالت پایه میشود، اما این افزایش عمدتاً در توکنهای ورودی است و در تولید با کشکردن پرامپت تا حد زیادی بازیافت میشود.
آیا این روش روی مدلهای مرزی هم اثر دارد؟
بله؛ در دامنه خطوط هوایی با ایجنت جیپیتی-۵.۵ دقت ۱۰ واحد و Pass^4 پانزده واحد بهبود یافت و امتیاز ۸۲ درصدی، صدر جدول را به این اجرا داد.
منبع: Hugging Face



