تصور کنید دستیار هوش مصنوعی شما در تمرین عالی عمل میکند، اما در اجرای زنده همان وظیفه را با مسیر متفاوتی انجام میدهد و شکست میخورد. این مشکل فقط یک صحنهی ناخوشایند نیست؛ در تولید، یک مسئلهی قابلیت اطمینان است: کاری که یک بار موفق شده ممکن است بار بعد با همان درخواست کاربر شکست بخورد. پژوهشگران IBM Research ابزاری ساختهاند که این بیثباتی را اندازه میگیرد و با «دستورالعملهای سازگاری» آن را تا نصف کاهش میدهد.
شکاف سازگاری: عددی که هیچکس گزارش نمیکند
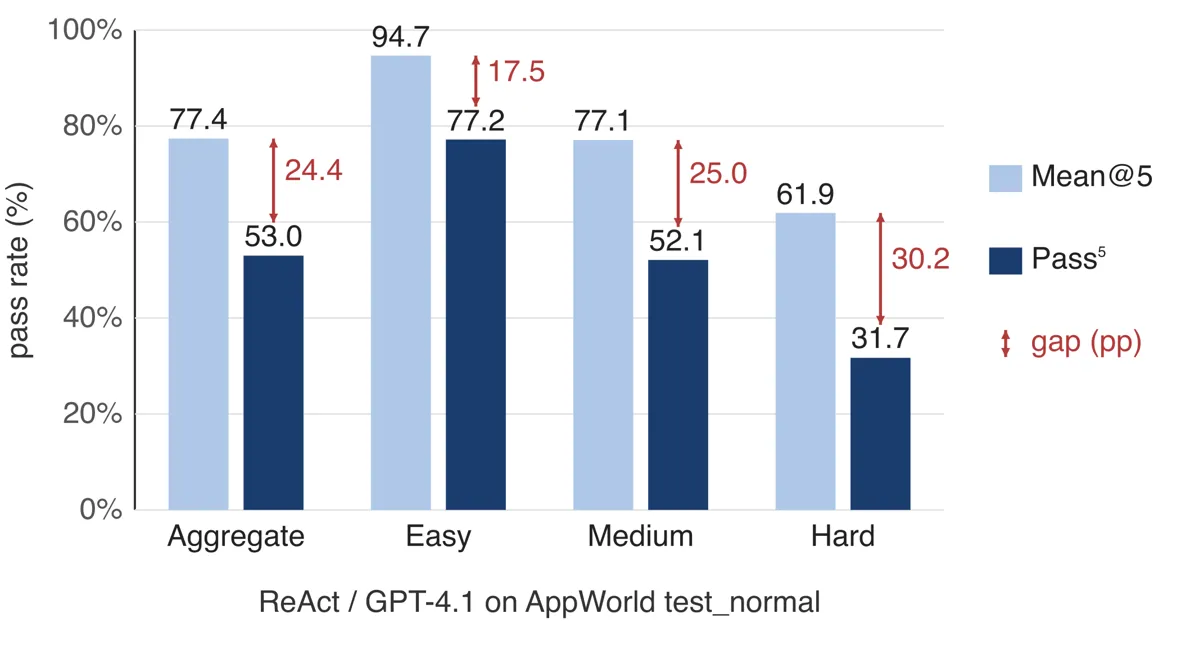
ارزیابی استاندارد عاملهای هوش مصنوعی معمولاً با معیار Mean@k انجام میشود: اجرای یک معیار k بار و میانگین گرفتن از نرخ موفقیت. این عدد روی همهی جدولهای رتبهبندی دیده میشود و همان چیزی است که «دقت ۷۷٪» در عمل معنا میدهد. اما این معیار به سؤالی که کاربر واقعی میپرسد پاسخ نمیدهد: اگر دقیقاً همین سؤال را دوباره بپرسم، باز هم موفق میشود؟
برای این سؤال، معیار Pass^k لازم است: کسری از وظایف که عامل در همهی k بار اجرا موفق میشود. در آزمایش روی AppWorld، یک عامل ReAct با مدل GPT-4.1 میانگین موفقیت ۷۷.۴٪ داشت، اما فقط در ۵۳.۰٪ از وظایف در هر ۵ بار اجرا موفق بود — یعنی ۲۴.۴ واحد درصد شکاف. در وظایف سخت، این شکاف به ۳۰ واحد درصد میرسد.
Pass^k همیشه ≤ Mean@k ≤ Pass@k است. Pass@k خوشبینانه میپرسد «آیا حداقل یکی از k تلاش موفق شد؟» و Pass^k بدبینانه میپرسد «آیا همهی تلاشها موفق شدند؟» — همان حروف، سؤالهای متضاد.
چرا عاملها تصمیمهای ناپایدار میگیرند؟
هر بار که یک عامل هوش مصنوعی تصمیم میگیرد — کدام API را صدا بزند، چه آرگومانی بدهد، آیا دوباره تلاش کند — آن تصمیم از یک توزیع احتمال روی توکنهای بعدی بیرون میآید. شکل این توزیع تعیین میکند که چقدر نویز برای تغییر نتیجه لازم است. توزیع «تیز» بیشتر جرم را روی یک توکن میگذارد و انتخاب ثابت میماند. توزیع «مسطح» جرم را بین چند توکن تقریباً برابر پخش میکند و برندهی آن نزدیک به پرتاب سکه است.
چون یک مسیر اجرا دهها تصمیم را زنجیر میکند، احتمال کوچک تغییر در هر مرحله به شانس بزرگی تبدیل میشود که برخی اجراها متفاوت شوند. این همان جایی است که شکاف ۲۴ واحدی از آن میآید. نکتهی مهم: این مشکل با تنظیمات decoding حل نمیشود. حتی با دمای صفر و seed ثابت، در یک endpoint میزبان، احتمالات کمی بین اجراها جابهجا میشوند و یک تساوی نزدیک میتواند امروز یکطرف و فردا طرف دیگر شود.
تشخیص، سپس اصلاح: تحلیلگر سازگاری و دستورالعملهای سازگاری
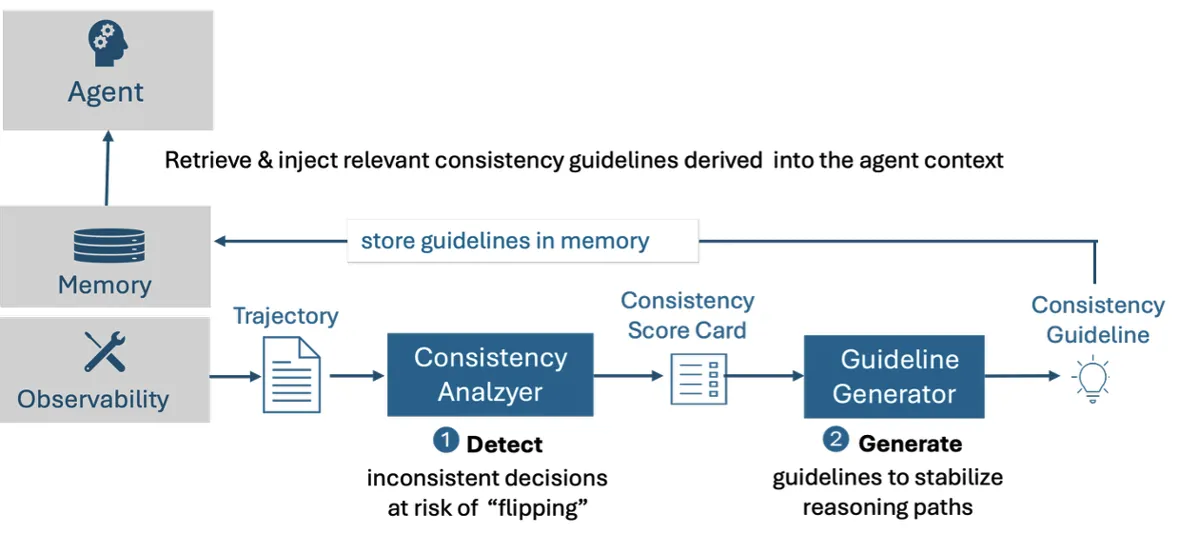
راهکار پژوهشگران یک خط لولهی دو مرحلهای است که به سیستم منبعباز ALTK-Evolve اضافه شده است. مرحلهی اول «تحلیلگر سازگاری» است: با یک مسیر اجرای ضبطشده، هر نقطهی تصمیم را با نمونهگیری کنترلشده دوباره پخش میکند و اندازه میگیرد که خروجی مدل چقدر در آن نقطه تغییر میکند. این کار فقط یک فراخوان مدل اضافی برای هر مرحلهی تصمیم نیاز دارد — نه ابزار جدید، نه تعامل با محیط، نه اجرای دوبارهی کل وظیفه. نتیجه یک کارت امتیاز است که دقیقاً نشان میدهد کدام تصمیمها در اجرای بعدی در معرض تغییر هستند.
مرحلهی دوم «تولید دستورالعملهای هدفمند» است. هر مرحلهی پرچمشده به یک دستورالعمل سازگاری در قالب استاندارد ALTK-Evolve تبدیل میشود. یک مثال واقعی از وظیفهی AppWorld:
«وقتی نشانگرهای چکباکس را در محتوای یادداشت میشمارید، از تطبیق regex مبتنی بر خط استفاده کنید نه شمارش زیررشتهی ساده — عنوان یادداشتها اغلب نماد نشانگر را در یک خط راهنما تکرار میکنند.»
نکتهی کلیدی این است که تحلیلگر بیثباتی را هدف میگیرد، نه شکست را. بنابراین مراحلی را میگیرد که عامل این بار درست انجام داده اما ممکن است بار بعد بهراحتی اشتباه کند.
نتایج: نصف شدن شکاف بدون از دست دادن دقت
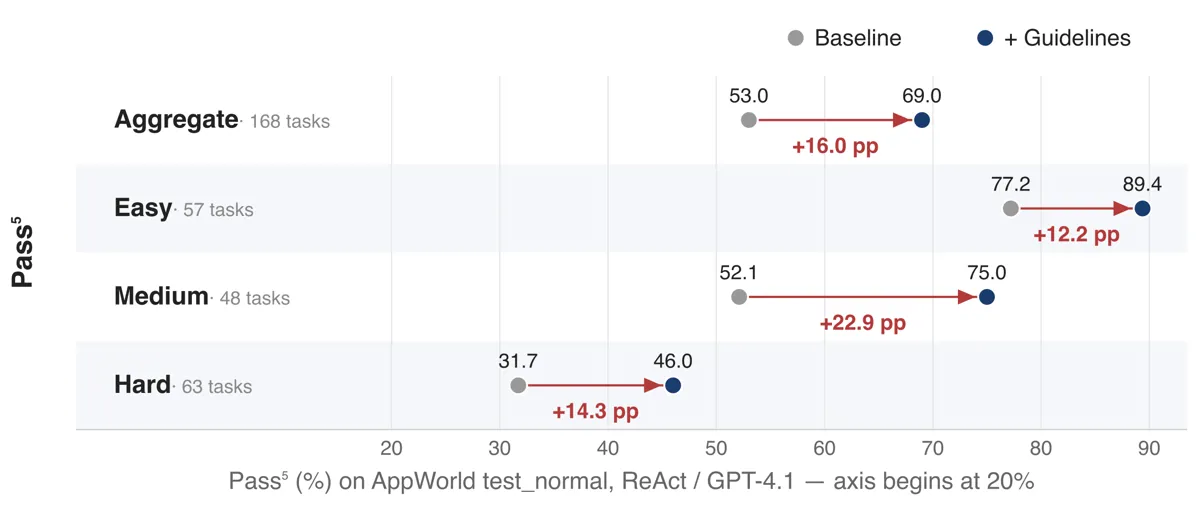
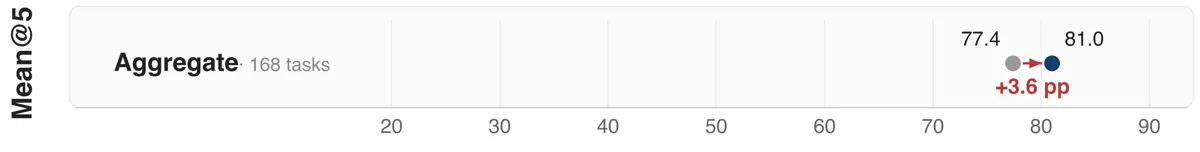
ارزیابی روی AppWorld test_normal با ۱۶۸ وظیفه و عامل ReAct روی GPT-4.1 انجام شد. دستورالعملهای سازگاری از یک مسیر اجرای پایه برای هر وظیفه تولید و روی ۵ اجرای تازه آزمایش شدند. نتیجه: شکاف سازگاری تقریباً نصف شد — از ۲۴.۴ واحد درصد به ۱۲.۰ واحد درصد. Pass^5 از ۵۳.۰٪ به ۶۹.۰٪ رسید و Mean@5 از ۷۷.۴٪ به ۸۱.۰٪ افزایش یافت.
بیشترین بهبود در وظایف متوسط و سخت بود: متوسط +۲۲.۹ واحد درصد (۴۴٪ نسبی) و سخت +۱۴.۳ واحد درصد (۴۵٪ نسبی). نکتهی مهم: Mean@5 هرگز کاهش نیافت — حفظ دقت میانگین یک الزام سخت بود، نه یک امتیاز اضافه.
دستورالعملها به وظایف مشابه نیز تعمیم مییابند. وقتی روی وظیفهای متفاوت اما مرتبط در همان سناریو اعمال شدند، Pass^5 را +۱۳.۰ واحد درصد افزایش دادند — فقط ۳ واحد کمتر از عدد وظیفهی یکسان. جالبتر اینکه با مدل ضعیفتر gpt-oss-120b، تعمیم به وظایف مشابه (+۸.۷ واحد درصد) حتی از بهبود وظیفهی یکسان (+۶.۰ واحد درصد) بیشتر بود، که نشان میدهد دستورالعملها الگوهای شکست واقعاً قابل استفاده را میگیرند، نه جزئیات یک مسیر خاص را.
اگر عامل هوش مصنوعی را به تولید میفرستید
- Pass^k را کنار Mean@k گزارش کنید. میانگینها نمیتوانند عامل قابلاعتماد را از عامل خوششانس تشخیص دهند؛ حتی k=3 شکافی را نشان میدهد که نمیدانستید دارید.
- انتظار داشته باشید شکاف با سختی وظیفه بیشتر شود. سختترین رده جایی است که یک عدد میانگین بیشترین گمراهی را ایجاد میکند.
- اول سراغ مدل بزرگتر نروید. سازگاری و توانایی دو محور مستقل هستند. مدل قویتر Mean@k را بالا میبرد اما لزوماً شکاف را کم نمیکند.
- تشخیص به نمرهدهنده و پخش دوباره نیاز ندارد. یک فراخوان LLM اضافی برای هر مرحلهی تصمیم کافی است — بدون حقیقت زمینی، بدون اجرای دوبارهی وظیفه. این همان چیزی است که آن را روی ترافیک تولید قابل استفاده میکند.
این رویکرد با سیستم منبعباز ALTK-Evolve در دسترس است و گزارش فنی کامل روی arXiv منتشر شده است. اگر اعداد دقتی که نمیتوانید روی وظایف خودتان تکرار کنید برایتان آشناست، پژوهشگران IBM از بازخورد شما دربارهی رفتارهای مستعد تغییر در عاملهای خودتان استقبال میکنند.
پرسشهای متداول
شکاف سازگاری (Consistency Gap) در ارزیابی عاملهای هوش مصنوعی چیست؟
تفاوت بین میانگین موفقیت (Mean@k) و موفقیت در همه تلاشها (Pass^k) است. مثلاً عاملی که بهطور میانگین ۷۷.۴٪ موفق میشود، فقط در ۵۳٪ وظایف در هر ۵ بار اجرا موفق است؛ یعنی ۲۴.۴ واحد درصد شکاف دارد.
چرا یک عامل هوش مصنوعی با وجود موفقیت در یک اجرا، در اجرای بعدی شکست میخورد؟
بهخاطر تصمیمهای «مسطح» در مدل زبانی؛ جایی که چند توکن شانس تقریباً برابری دارند و کوچکترین تغییر در محاسبات میتواند نتیجه را برگرداند. این مشکل با تنظیم دما یا seed حل نمیشود.
راهکار Consistency Guidelines در ALTK-Evolve چگونه کار میکند؟
ابتدا با تحلیلگر سازگاری، نقاط تصمیم حساس در مسیر اجرا شناسایی میشوند؛ سپس برای هر نقطه، دستورالعملهایی تولید و در زمان استنتاج به مدل تزریق میشود تا تصمیم پایدار بماند.
آیا مدل بزرگتر شکاف سازگاری را کم میکند؟
خیر؛ سازگاری و توانایی دو محور مستقل هستند. مدل قویتر میانگین موفقیت را بالا میبرد اما لزوماً شکاف را کاهش نمیدهد. راهکار اصلی، شناسایی و تثبیت نقاط تصمیم حساس است.
منبع: Hugging Face



