کتابخانه TorchNeuron یک بکاند بومی جدید برای PyTorch روی سختافزار AWS Trainium ارائه میدهد. این امکان، اجرای مدلهای هوگینگفیس را سادهتر کرده و آنها را به دستگاهی مانند دیگر شتابدهندهها تبدیل میکند.
معرفی TorchNeuron
TorchNeuron در واقع یک پلاگین برای PyTorch است که یک بکاند جدید برای سختافزار Trainium شرکت آمازون ایجاد میکند. این بکاند از حالت eager، قابلیت torch.compile و همچنین APIهای توزیعشده بومی PyTorch مانند FSDP (Fully Sharded Data Parallel) و TP (Tensor Parallelism) پشتیبانی میکند.
از تاریخ ۲۰ اکتبر ۲۰۲۶ (۲۹ مهر ۱۴۰۵)، TorchNeuron بهصورت یک نسخه بتای عمومی در دسترس خواهد بود. پژوهشگران و توسعهدهندگان میتوانند آن را با دستور pip install torch-neuronx نصب کنند.
بکاند جدید و رابط بومی در کتابخانههای هوگینگفیس
تاکنون، تجربه استفاده از هوگینگفیس روی سختافزارهای Trainium و Inferentia (تراشههای هوش مصنوعی طراحیشده بهترتیب برای آموزش مقرونبهصرفه و استنتاج در مقیاس) از طریق کتابخانه optimum-neuron ارائه میشد. این کتابخانه بر پایه بسته torch-neuronx و در نهایت PyTorch XLA بنا شده بود. اگرچه در زمان خود انتخاب طبیعیای محسوب میشد، اما کاربران را مجبور میکرد مانند یک کامپایلر فکر کنند: تانسورهای lazy به جای اجرای eager، فقط شکلهای استاتیک و نیاز به کامپایل مجدد برای هر شکست در گراف.
TorchNeuron این رویکرد را تغییر میدهد. این کتابخانه مستقیماً در PyTorch ادغام شده و neuron را بهعنوان یک دستگاه بومی معرفی میکند که از اجرای eager، primitiveهای توزیعشده خود PyTorch مانند DTensor و FSDP2 و همچنین torch.compile پشتیبانی میکند.
برای کتابخانههای هوگینگفیس، Trainium اکنون دستگاهی مانند هر دستگاه دیگری است. کتابخانههای Transformers، Diffusers، Accelerate، PEFT و TRL بهصورت مستقیم روی آن اجرا میشوند، با همان کلاسها و اسکریپتهایی که روی هر شتابدهنده دیگری استفاده میکنید. از این پس به کاربران Neuron توصیه میشود مستقیماً از این کتابخانهها استفاده کنند و از مسیر Optimum Neuron عبور نکنند.
پشتیبانی از Transformers
با TorchNeuron، ۸۹٪ از ۱۰۰ معماری پراستفاده مدلهای تولید متن، بدون نیاز به تغییرات خاص پشتیبانی میشوند. این رقم در Optimum Neuron نسخه ۰.۴.۵ تنها ۴۶٪ بود. برای استفاده، کافی است آرگومان device_map=neuron را در کد خود قرار دهید تا مدل به دستگاههای Neuron منتقل شود.
آموزش روی Trainium نیز اکنون از کتابخانههای مشابهی مانند Transformers، Accelerate، PEFT و TRL استفاده میکند و دیگر نیازی به یک Trainer اختصاصی یا یک انشعاب خاص Neuron از کد مدل نیست. یک اسکریپت استاندارد تنظیمظریف TRL با تنها چند تنظیم خاص Neuron روی یک نمونه Trainium اجرا میشود.
موازیسازی بهصورت بومی توسط Transformers مدیریت میشود. با قرار دادن یک DistributedConfig همراه با اندازههای tensor-parallel و FSDP در model_init_kwargs، مدل در حین بارگذاری وزنها shard میشود. Trainer متوجه میشود که مدل از قبل توزیعشده است و آن را دوباره wrap نمیکند.
هیچ بخشی در اسکریپت به Trainium گره نخورده است: همان کد روی هر سختافزاری اجرا میشود. چند نکته هنگام اجرا روی Trainium值得 دانستن است:
- شکلهای استاتیک: اسکریپت automatic dynamic shapes را در torch.compile غیرفعال کرده و از packed sequences استفاده میکند.
- فعالسازی torch.compile: تنها با ارسال --torch_compile true، روی یک نمونه Trainium، torch.compile دستگاه را تشخیص داده و بکاند Neuron را بهطور خودکار انتخاب میکند.
- غیرفعالسازی بارگذاری ناهمگون وزنها: بارگذاری ناهمگون built-in وزنها در Transformers روی Neuron پشتیبانی نمیشود، بنابراین فعلاً با متغیر محیطی HF_DEACTIVATE_ASYNC_LOAD=1 آن را غیرفعال میکنیم.
خروجی trainer.save_model یک چکپوینت استاندارد Transformers است که هیچ وابستگی به Neuron ندارد و میتوان آن را در هوگینگفیس هاب آپلود و روی هر سختافزار دیگری بارگذاری کرد.
پشتیبانی از Diffusers
بسیاری از pipelineهای کتابخانه Diffusers با TorchNeuron در حالت eager و compiled سازگار هستند. مدلهایی مانند FLUX.1-dev، FLUX.2، Qwen-Image، Qwen-Image-2.1 و H3 نیز با tensor parallelism سازگارند تا بیشترین بهره را از دستگاههای Neuron ببرید.
تعداد بیشتری از pipelineها در آینده از TP پشتیبانی خواهند کرد. اگر pipeline مورد علاقه شما هنوز سازگار نیست، میتوانید با دنبال کردن راهنمای مربوطه پشتیبانی را به آن اضافه کنید.
هستههای (Kernels) بهینهشده Neuron
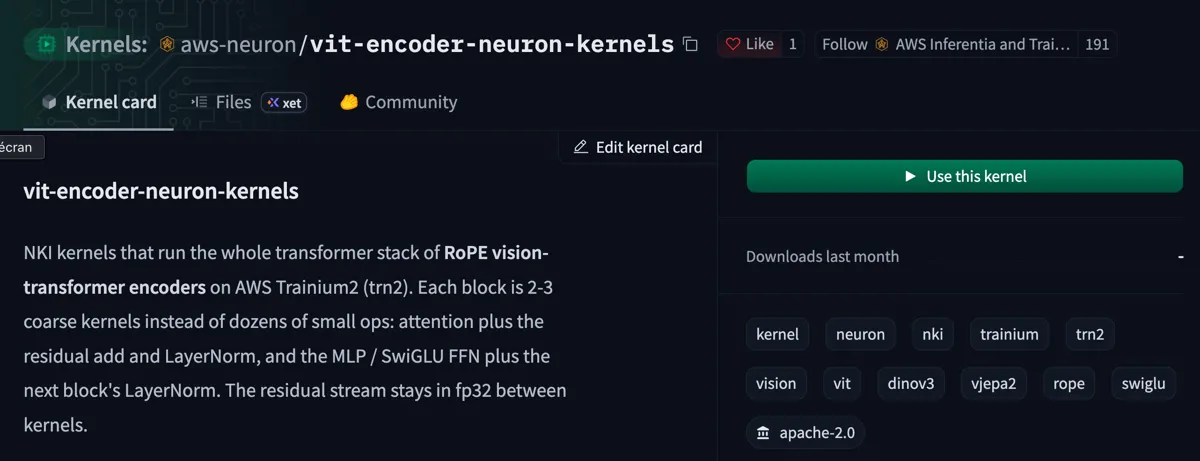
هستههای بهینهشده تیم Neuron را در هوگینگفیس هاب بررسی کنید. تعداد بیشتری از این هستهها در دسترس قرار خواهند گرفت تا مدلهای شما را سرعت ببخشند. هستههای Neuron را میتوان با استفاده از Neuron Kernel Interface نوشت که کنترل سطح پایینتری برای بهینهسازی عملیات فراهم میکند.
بهعنوان مثال، میتوانید از این هسته برای سرعت بخشیدن به مدلهای Vision Transformers خود استفاده کنید که تا ۲.۴ برابر سرعت روی Trainium را به همراه دارد.
| مورد | توضیح |
|---|---|
| پشتیبانی از تولید متن | ۸۹٪ از ۱۰۰ معماری پراستفاده |
| نیاز به Optimum Neuron | خیر، کتابخانهها مستقیم اجرا میشوند |
| خروجی آموزش | چکپوینت استاندارد و قابل انتقال |
| حالت اجرا | Eager، Compiled و پشتیبانی از TP/FSDP |
با معرفی TorchNeuron، فاصله بین توسعه با PyTorch روی GPU و اجرا روی سختافزارهای خاص مانند AWS Trainium به حداقل میرسد. این یک گام مهم به سمت دموکراتیکتر کردن دسترسی به سختافزارهای تخصصی برای جامعه هوش مصنوعی است.
پرسشهای متداول
TorchNeuron چیست؟
TorchNeuron یک پلاگین PyTorch است که یک بکاند جدید برای سختافزار AWS Trainium فراهم میکند و از حالت eager، torch.compile و APIهای توزیعشده بومی مانند FSDP پشتیبانی میکند.
آیا برای استفاده از Trainium دیگر به Optimum Neuron نیاز داریم؟
خیر. با وجود TorchNeuron، کتابخانههای هوگینگفیس مانند Transformers و Diffusers بهصورت مستقیم روی Trainium اجرا میشوند و دیگر نیازی به واسطهای مانند Optimum Neuron نیست.
پشتیبانی از تولید متن در Transformers با TorchNeuron چقدر بهبود یافته؟
با TorchNeuron، ۸۹٪ از ۱۰۰ معماری پراستفاده مدلهای تولید متن، بدون نیاز به تغییرات خاص پشتیبانی میشوند؛ این رقم در Optimum Neuron نسخه ۰.۴.۵ تنها ۴۶٪ بود.
آیا مدل آموزشدیده روی Trainium را میتوان روی سختافزار دیگر استفاده کرد؟
بله. خروجی trainer.save_model یک چکپوینت استاندارد Transformers است که هیچ وابستگی به Neuron ندارد و میتوان آن را در هوگینگفیس هاب آپلود و روی هر سختافزار دیگری بارگذاری کرد.
منبع: Hugging Face



