انویدیا مدل پایهٔ تازهای به نام Kumo Relational (کومو رلیشنال) معرفی کرده که پیشبینی روی دادههای رابطهای را بدون آموزش اختصاصی و بدون مهندسی ویژگی انجام میدهد. این مدل بهجای تبدیل جدولها به یک جدول تخت، مستقیم روی خود پایگاهداده کار میکند و به گفتهٔ سازندگانش نخستین مدل پایهٔ چندنمونهای (few-shot) است که در بنچمارکهای رایج دادهٔ رابطهای از مدلهای یادگیری نظارتشده جلو میزند.
از مدلهای زبانی تا دادههای رابطهای
مدلهای پایه یک بار مسیر زبان و بینایی را تغییر دادند: بهجای یک مدل جداگانه برای هر وظیفه با خط لولهٔ اختصاصی توکنسازی و ویژگیسازی، یک مدل عمومی آمد که هم دقیقتر بود، هم سادهتر به تولید میرسید و هم راه را برای کاربردهای ایجنتی باز کرد.
انویدیا میگوید همین جابهجایی برای دادههای ساختاریافته در جریان است. پایگاهدادههای رابطهای پشت بسیاری از تصمیمهای حیاتی کسبوکار هستند، اما مدلسازی پیشبینانه روی آنها هنوز به هفتهها مهندسی ویژگی، آموزش وظیفهمحور و خط لولهٔ تنظیمشده نیاز دارد. سه استدلال مطرحشده برای تغییر این وضعیت چنین است:
- دقت بیشتر از همین امروز: مدل پایه بهعنوان جایگزین آمادهٔ خط لولههای فعلی، در وظایف طبقهبندی RelBench V1 بهطور میانگین نزدیک به ۴ واحد AUROC بهتر از درختهای تقویتشدهٔ گرادیانی روی ویژگیهای مهندسیشده عمل میکند.
- سادگی و چابکی: یک مدل پیشآموزشدیده جای خط لولههای جداگانهٔ هر وظیفه را میگیرد؛ پیشبینی تازه به یک پرسش تبدیل میشود، نه یک پروژه.
- ایجنتهایی که پیشبینی میکنند: مدلهای زبانی به ایجنتها خواندن، نوشتن و استدلال را دادند؛ مدل پایهٔ دادهٔ رابطهای توان پیشبینی رویداد بعدی را اضافه میکند. Kumo Relational از ابتدا برای فراخوانی توسط ایجنت ساخته شده و زبان پرسش پیشبینی (PQL) رابط سادهای در اختیار آن میگذارد.
اگر دربارهٔ تفاوت رفتار ایجنتها در اجراهای مختلف کنجکاو هستید، نوشتهٔ چرا دستیار هوش مصنوعی شما گاهی موفق میشود و گاهی نه؟ به همین شکاف میپردازد.
Kumo Relational چطور کار میکند
بیشتر مدلهای پایه برای دادهٔ ساختاریافته روی یک جدول تخت کار میکنند، در حالی که دادهٔ واقعی در پایگاهدادهٔ رابطهای زندگی میکند: کاربرانی که به سفارشها و محصولات وصلاند و همه در زمان تغییر میکنند. تختکردن این روابط با تجمیع دستی، مثل «میانگین ارزش سفارش در ۳۰ روز گذشته»، هم بخشی از سیگنال ساختاری را از بین میبرد و هم نیروی انسانی زیادی میخواهد.
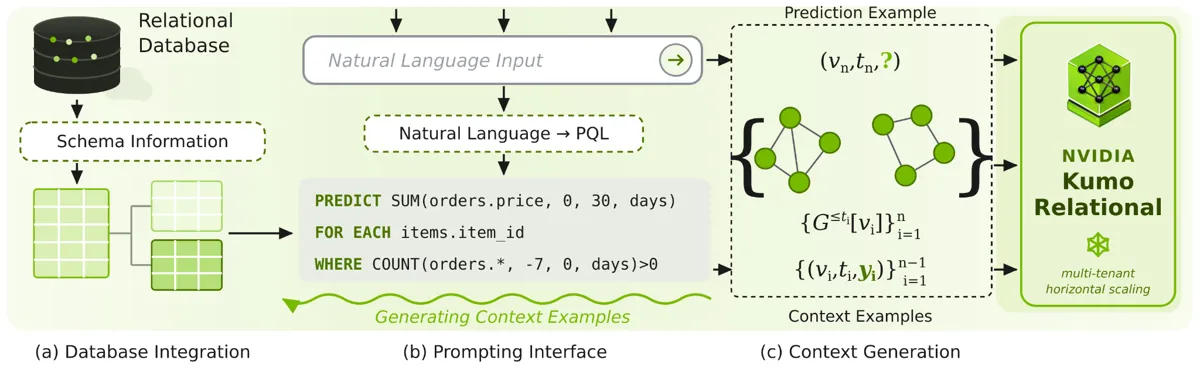
Kumo Relational روی خودِ پایگاهداده کار میکند و جدولها، کلیدهای خارجی و برچسبهای زمانی را محترم میشمارد. یک بار روی دادهٔ رابطهای مصنوعی که بازتابدهندهٔ دادهٔ واقعی است پیشآموزش میبیند و هر وظیفهٔ تازه را با یادگیری درونمتنی سازگار میکند؛ در زمان استنتاج تا ۱۰٬۰۰۰ نمونهٔ زمینه میخواند. هر نمونه، یک زیرگراف محلی حول یک موجودیت در یک نقطهٔ زمانی را با هدف واقعیاش جفت میکند، مثلاً «این کاربر ریزش کرد» یا «این کالا ۱۴۲ واحد فروخت».
تولید خودکار زمینه
وظیفهها در زبان پرسش پیشبینی (Predictive Query Language یا PQL) نوشته میشوند؛ رابطی اعلانی که در آن میگویید چه چیزی را میخواهید پیشبینی کنید، نه چگونه. برای وظایف زمانی، مدل وضعیتهای تاریخی پایگاهداده را بازپخش میکند: زیرگرافهای موجودیتمحور را تا یک برچسب زمانی نمونهگیری میکند و هر هدف را از رویدادهای پس از آن زمان محاسبه میکند، اما فقط دادهٔ پیش از آن را به مدل میدهد. این کار از نشت داده جلوگیری میکند.
استدلال درون جدولها و میان جدولها
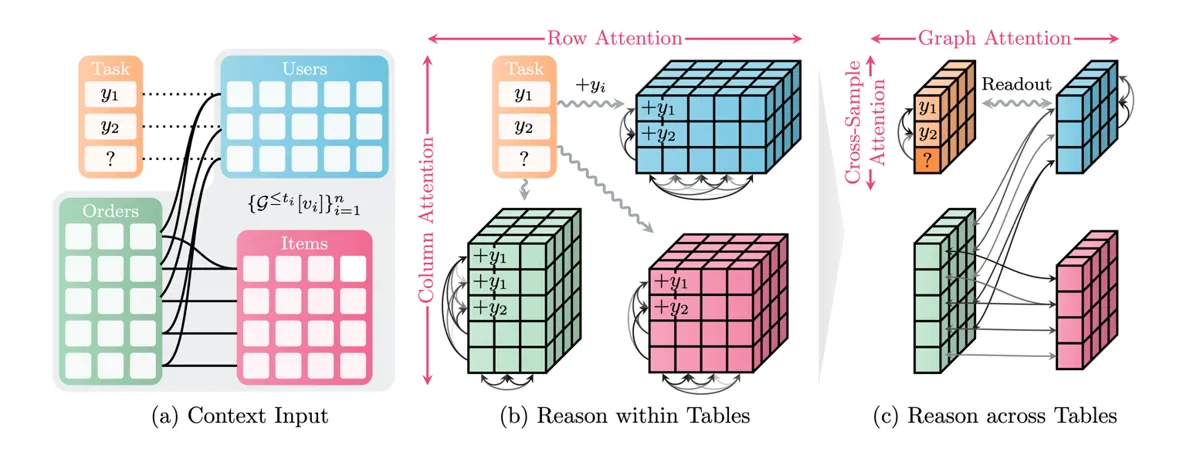
یک شبکهٔ سبک هر جدول را جداگانه پردازش میکند و میان توجه ستونی (ارتباط مقادیر در یک ستون) و توجه سطری (ارتباط ویژگیها در یک سطر) جابهجا میشود. مدل یاد میگیرد کدام ستونها و سطرها برای پیشبینی جاری مهماند و نویز را پیش از انتشار فیلتر میکند.
سپس شبکهٔ بزرگتری جاسازی سطرها را از طریق توجه گرافی روی روابط کلید اصلی و کلید خارجی توزیع میکند و میان نمونههای زمینه توجه متقابل برقرار میکند. استدلال رابطهای همینجا رخ میدهد؛ مثلاً پیوند دادن پروفایل یک کاربر به تاریخچهٔ تراکنشهایش. چون این مرحله روی جاسازی سطرها کار میکند و نه روی تکتک سلولهای هر جدول، هزینه بهصورت درجهدوم رشد نمیکند و زمینههای بزرگ و زیرگرافهای عمیقتر قابل مدیریت میمانند.
پیشآموزش با دادهٔ کاملاً مصنوعی
Kumo Relational روی دادهٔ رابطهای کاملاً مصنوعی پیشآموزش دیده که برای بازتاب دادن پایگاهدادههای واقعی با پرسشهای پیشبینی متنوع شبیهسازی شده است. آموزش مرحلهبهمرحله پیش میرود؛ از جدولهای تک تا ساختارهای رابطهای پیچیدهتر.
پایگاهدادههای متنوع لازم برای چنین پیشآموزشی بهندرت عمومیاند، پس دادهٔ مصنوعی این خلأ را پر میکند. مولد Kumo Relational بر روش PluRel (Kothapalli و همکاران، ICML 2026) بنا شده که مولدهای تکجدولی را به پایگاهدادهٔ رابطهای کامل گسترش میدهد و اعضایی از تیم Kumo در توسعه و نگارش مقالهٔ اصلی آن نقش داشتهاند. PluRel هر پایگاهداده را در سه مرحله میسازد: یک شِما، پیوندهای کلید خارجی میان سطرهایی که مانند دادهٔ واقعی خوشهبندی میشوند، و مقادیر ستونها از مدلهای علّی ساختاری با روندهای زمانی و وابستگیهای میانجدولی. تولید سبک است، بنابراین دادهٔ پیشآموزش عملاً بیپایان است؛ مقالهٔ PluRel نشان میدهد که خطای پیشآموزش با افزودن پایگاهدادههای مصنوعی از یک قانون توانی پیروی میکند و این بهبود به پایگاهدادههای واقعی هم سرایت میکند.
در پایان این مسیر، مدل یاد میگیرد بهجای تکیه بر تجمیعهای ثابت، اطلاعات را میان جدولها فیلتر، همبسته و خلاصه کند. جایی که دقت حداکثری اهمیت دارد، میتوان Kumo Relational را روی یک داده و وظیفهٔ مشخص تنظیم دقیق کرد.
عملکرد در بنچمارکها
ارزیابی روی ۴۱ بنچمارک در ۱۵ پایگاهدادهٔ رابطهای از RelBench V1 و V2، SAP SALT و 4DBInfer انجام شده؛ در حوزههای تجارت الکترونیک، پزشکی، سازمانی، اجتماعی و دانشگاهی. هیچکدام از این دادهها در پیشآموزش دیده نشده بودند و مدل از قویترین مدلهای نظارتشده در هر دو دستهٔ طبقهبندی و رگرسیون جلوتر بوده است.
| مقایسه | معیار | نتیجه |
|---|---|---|
| درختهای تقویتشدهٔ گرادیانی با ویژگیهای مهندسیشده (وظایف طبقهبندی RelBench V1) | AUROC | نزدیک به ۴ واحد بهتر، بهطور میانگین |
| XGBoost روی ویژگیهای مهندسیشده در SAP SALT | MRR | ۷ واحد بهتر بدون تنظیم دقیق، ۱۳ واحد پس از تنظیم دقیق |
| مجموعههای بزرگ AutoGluon در SAP SALT | MRR | ۸٪ بهتر، و ۱۶٪ پس از تنظیم دقیق |
| مدلهای پایهٔ جدولی اخیر در SAP SALT | MRR | نزدیک به ۲۵٪ بهتر |
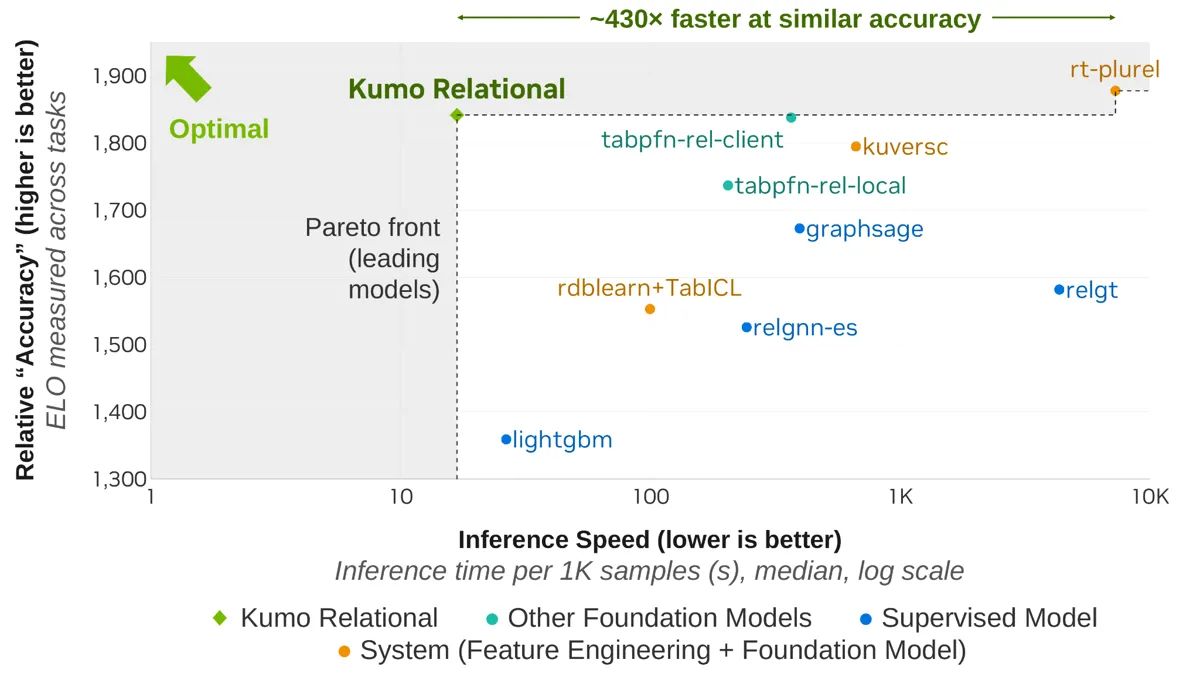
در لیدربورد RelArena-α که مدلها و سیستمهای رابطهای را روی RelBench V1 مقایسه میکند، Kumo Relational بدون هیچ تنظیمی روی مرز پارتو دقت و کارایی مینشیند: حدود ۱۷ ثانیه و امتیاز Elo برابر ۱٬۸۴۲. بالاترین امتیاز جدول متعلق به rt-plurel با Elo ۱٬۸۷۸ در حدود ۷٬۳۰۰ ثانیه است، یعنی تقریباً ۴۳۰ برابر کندتر.
انویدیا میگوید مدل در شرایط سخت هم دوام میآورد: با تنها ۰٫۲٪ از دادهٔ آموزشی بهعنوان زمینه عملکرد خوبی دارد، وقتی تا ۷۵٪ از پیوندهای کلید خارجی حذف شوند پایدار میماند و با افزودن ستونهای نویزی زیاد تقریباً افت نمیکند. نمونهای از کاربردهای پیشبینی، مثل تشخیص تقلب، در نوشتهٔ مدل تشخیص خودکار کلاهبرداری در دستگاههای موبایل هم بررسی شده است.
محدودیتها
بهترین عملکرد این مدل روی دادهای است که روابط معنادار و پویایی زمانی دارد، مانند رفتار کاربر در طول زمان. در وظایفی با مجموعهٔ آموزشی بسیار بزرگ، مدلهای نظارتشدهٔ اختصاصی ممکن است همچنان از پیشبینی درونمتنی کمی جلو بزنند؛ در بنچمارکهای این مقاله حداکثر ۱۰٬۰۰۰ نمونهٔ زمینه استفاده شده و تنظیم دقیق دقیقاً برای همین حالت در نظر گرفته شده است. همچنین سیگنال پیشبینی باید در تعداد محدودی گام از موجودیت هدف قابل دسترسی باشد؛ توصیه این است که با پرسشی متمرکز روی چند جدول مرتبط شروع کنید و گراف را در صورت نیاز گسترش دهید.
چطور میتوان امتحانش کرد
Kumo Relational یادگیری درونمتنی را بهصورت بومی روی پایگاهداده اجرا میکند: در حافظه، از طریق رابطهای پایگاهداده و انبار داده، یا با یک موتور گراف اختصاصی که بیش از ۵۰۰ میلیارد سطر را با ورودی/خروجی نگاشتشده در حافظه و سرعت تا ۵ گیگابایت بر ثانیه پوشش میدهد.
این مدل در کتابخانهٔ تازهمنتشرشده و بومیGPU انویدیا برای مدلهای دادهٔ ساختاریافته در دسترس است؛ همان کتابخانهٔ متنبازی که مدل خواهر آن، Kumo Tabular، را هم توانمند میکند. وزنها در نخستین استفاده از Hugging Face Hub دانلود میشوند، پس میتوان مدل را در یک نوتبوک مجهز به GPU بارگذاری کرد و مستقیم پیشبینی گرفت. برای اجرای مدل بهعنوان سرویس جداگانه هم میتوان آن را به شکل NVIDIA NIM مستقر کرد و کلاینت متنباز structured-data-models-client را به آن نشانه گرفت؛ پرسش پیشبینی را در PQL مینویسید و کلاینت نمونههای زمینه و جدولهای مرتبط را جمع میکند و درخواست را میفرستد.
کد این پروژه با مجوز Apache 2.0 و وزنهای مدل زیر توافقنامهٔ OpenMDW نسخهٔ ۱.۱ منتشر شدهاند. انویدیا تأکید میکند که هوش مصنوعی قابلاعتماد مسئولیتی مشترک است و توسعهدهندگان باید همراه با تیم مدل اطمینان حاصل کنند که مدل با نیازهای حوزه و کاربردشان سازگار است.
پرسشهای متداول
Kumo Relational برای پیشبینی به آموزش اختصاصی نیاز دارد؟
نه. این مدل از یادگیری درونمتنی استفاده میکند و در زمان استنتاج تا ۱۰٬۰۰۰ نمونهٔ تاریخی را بهعنوان زمینه میخواند و در یک گذر رو به جلو پیشبینی میکند. برای بیشترین دقت میتوان آن را روی داده و وظیفهٔ مشخص تنظیم دقیق کرد.
Kumo Relational روی چه حجمی از داده کار میکند؟
به گفتهٔ انویدیا تا پایگاهدادههایی با بیش از ۵۰۰ میلیارد سطر مقیاس میپذیرد و از موتور گرافی استفاده میکند که با ورودی/خروجی نگاشتشده در حافظه تا ۵ گیگابایت بر ثانیه کار میکند.
این مدل در کدام بنچمارکها ارزیابی شده است؟
در ۴۱ وظیفه روی ۱۵ پایگاهداده از RelBench V1 و V2، SAP SALT و 4DBInfer در حوزههای تجارت الکترونیک، پزشکی، سازمانی، اجتماعی و دانشگاهی. هیچکدام از این دادهها در پیشآموزش دیده نشده بودند.
محدودیت اصلی Kumo Relational چیست؟
بهترین عملکرد را روی دادههایی با روابط معنادار و پویایی زمانی دارد. در وظایفی با مجموعهٔ آموزشی بسیار بزرگ، مدلهای نظارتشدهٔ اختصاصی ممکن است همچنان کمی بهتر باشند.
منبع: Hugging Face



