MonsterHouse یک پروجکشن تعاملی هالووین است که روی مدلهای باز NVIDIA Nemotron (انویدیا) ساخته شده: خانهای بداخلاق با صدای ناخدای یک کشتی دزدان دریایی که به بچههایی که شب هالووین برای گرفتن شکلات در میزنند جواب میدهد و فقط با «لطفاً» نرم میشود. سازندهٔ آن که در انویدیا کار میکند، کل زنجیرهٔ شنیدن، فکر کردن، حرف زدن و انیمیشن دهان را روی یک ورکاستیشن اجرا کرده است.
خانهای که گوش میدهد و غر میزند
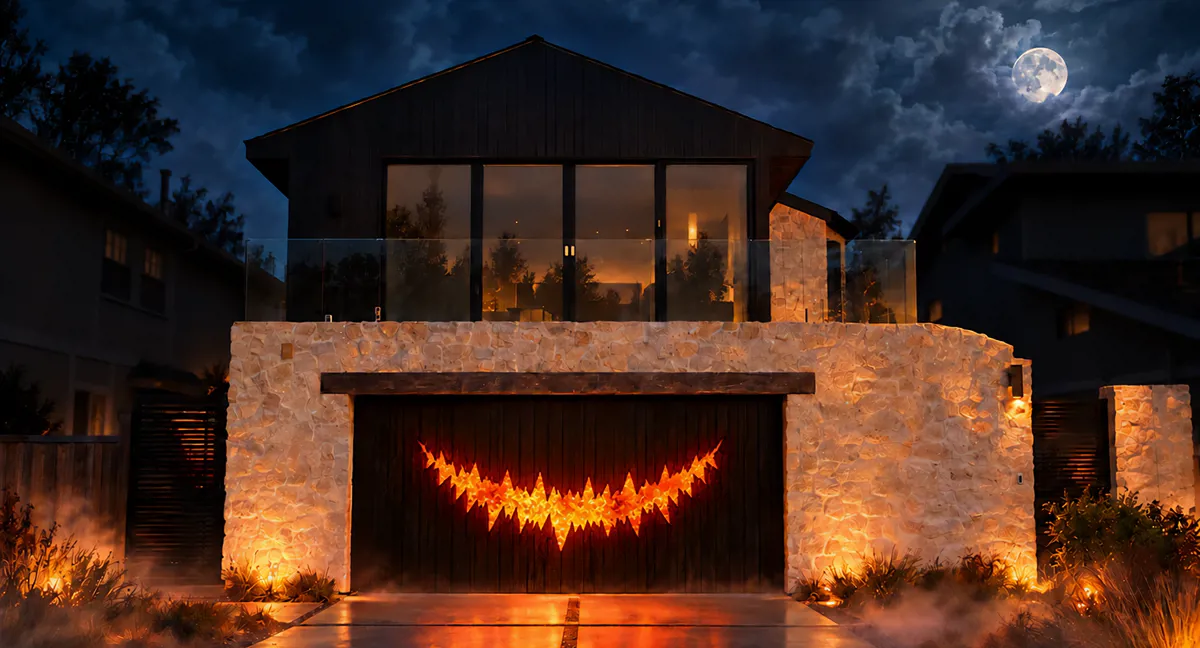
ایدهٔ اول ساده بود: در شب هالووین خانه باید مسئول پخش شکلات باشد، اما نه ترسناک، بلکه بداخلاقتر از آن که کسی تحملش کند. راهحل سازنده این بود که به درِ گاراژ یک دهان بدهد و به آن یاد بدهد غر بزند. حاصل، ساختمانی است با داستانهای دزدان دریایی، لبخندی آتشین و نقطهضعفی مشکوک در برابر واژهٔ «لطفاً».
پشت این نمایش، مجموعهای از مدلهای باز کار میکند که هر کدام یک وظیفه دارند:
| بخش | ابزار |
|---|---|
| شنیدن | NVIDIA Nemotron 3 ASR (نسخهٔ استریم انگلیسی، فایل nemotron-speech-streaming-en-0.6b.q8_0.gguf) |
| فکر کردن | Nemotron 3.5 Bolt E4B 4GB بههمراه یک آداپتر LoRA برای شخصیت |
| صحبت کردن | Magpie TTS Zeroshot با تکیه بر یک نمونهٔ صوتی کوتاه از شخصیت |
| انیمیشن دهان | Audio2Face-3D برای تبدیل گفتار تمیز به حرکت لب در Unreal Engine 5 |
| دیدن (اختیاری) | Nemotron 3 Nano Omni برای توصیف لباسها، بههمراه YOLO و ByteTrack برای شمارش و ردیابی |
| هماهنگی | NVIDIA Nemotron Voice Agent روی یک ورکاستیشن |
سختافزار هم یک ورکاستیشن است: کارت RTX PRO 6000 Blackwell Max-Q و کارت RTX PRO 4000 Blackwell.
دهانی از تختههای کهنه
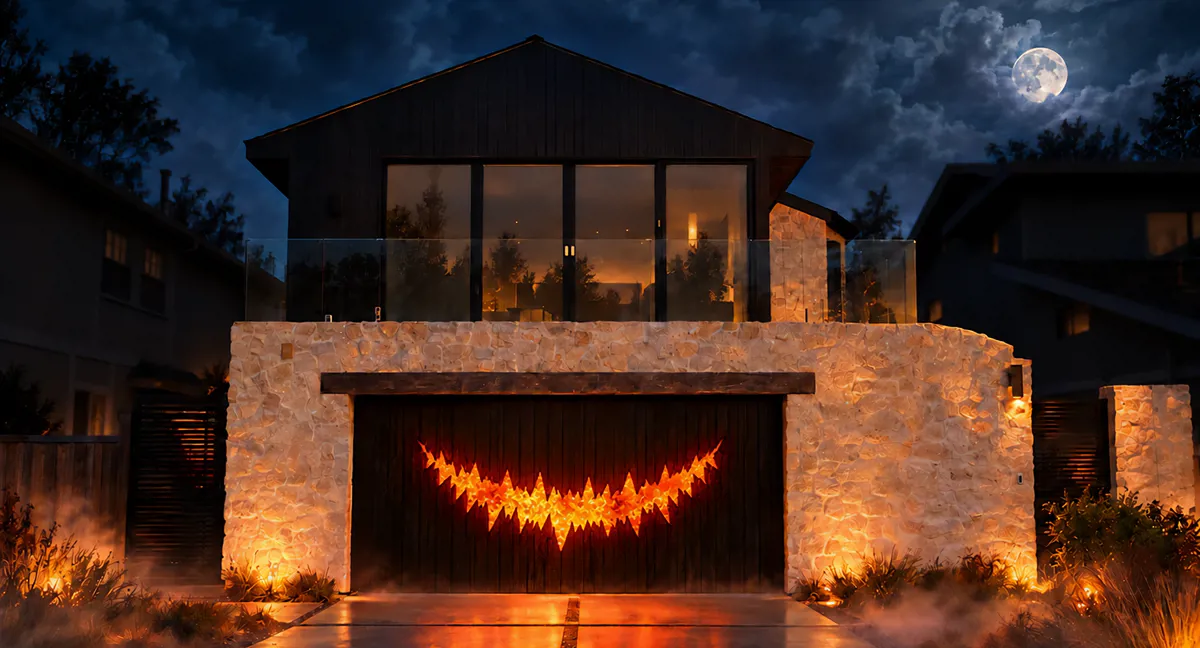
اول دهان ساخته شد. تصور این بود که تختههای درِ چوبی گاراژ به لبهایی ناهموار تبدیل شوند و شعلههای آتش از پشت آن، مسیر ورودی خانه را روشن کند. خانه باید باستانی، پراحساس و کمی آزرده از وجود بازدیدکنندهها به نظر میرسید.
ساخت ریگ انیمیشن اختصاصی یکی از زمانبرترین بخشهای پروژه بود. بعد از رسیدن به نتیجهٔ قابلقبول، شکلهای حالت چهره طوری صادر شدند که بعداً Audio2Face-3D بتواند آنها را متحرک کند. مش شخصیت (SkelMesh) در Autodesk Maya ساخته و به Unreal Engine منتقل شد و آتش و جلوههای مجازی پشت در اضافه شدند. چون خانه چشم، ابرو و پلکزدن ندارد، از نظر فنی هیولایی نسبتاً کمهزینه است.
چطور به خانه بیادبی یاد دادیم
خانه به گذشتهای نیاز داشت که بهاندازهٔ اخلاقش کجخلق باشد؛ بنابراین سازنده پشتداستانی ساخت: خانه از تیرهای یک کشتی دزدان دریایی غرقشده ساخته شده و گذشتهٔ طوفانیاش آن را تسخیر کرده است. حالا غرولندهای دریایی دلیل داشتند.
اجرا هم به یک مسیر نیاز داشت؛ مسیری از خوشآمد تا خداحافظی که در میانه راه شکلات هم پخش شود. اول خانه بازدیدکننده را با جملههایی مثل «سرم شلوغه، برو همسایهها رو اذیت کن!» رد میکند. اما اصرار کار خودش را میکند؛ یک «لطفاً» میتواند فوراً یخ او را آب کند و «متشکرم» خداحافظی گرمی به همراه دارد. به گفتهٔ سازنده، نکتهٔ مهم این است که وقتی بازدیدکننده خانه را راضی کرد، راضی بماند و لازم نباشد کسی با همان در گاراژ دو بار چانه بزند.
نگهداشتن وضعیت گفتوگو، مثل اینکه چه کسی «لطفاً» گفته، در منطق برنامه انجام میشود، نه با اتکا به حافظهٔ مدل. بعد از آزمایش بیش از یک دوجین مدل، انتخاب نهایی Nemotron 3.5 Bolt E4B 4GB بود؛ مدلی باز و کوچک که برای ایجنتهای گفتاری محلی و شخصیتهای تعاملی ساخته شده. نسخهٔ کوانتایز چهاربیتی (همان «4GB») مدل پیشفرض پاسخدهی است و نسخهٔ BF16 برای مقایسه در دسترس است. سازنده که در انویدیا کار میکند، Bolt E4B را پیش از انتشار عمومی آزموده و آن را با وجود ردپای کوچکتر از رقبای اصلی، Qwen3 30B-A3B و Qwen 3.6 35B-A3B، انتخاب مناسبی دیده است.
برای شخصیتسازی، مجموعهای با بیش از ۵۰۰۰ گفتوگوی چندنوبتی ساخته شد تا برای هر مدل قابلقبولی یک آداپتر LoRA آموزش ببیند. آموزش بعضی آداپترها حدود یک ساعت و بعضی چند ساعت طول کشید و یک ایجنت محلی همهٔ مراحل و ارزیابیها را اجرا میکرد؛ کارهایی که شبها یا در فاصلهٔ کار روزانه انجام میشد. کیفیت نهایی با بررسی پیوستگی، زمانبندی و لحن پاسخها و سپس با گوش دادن به اجرای واقعی سنجیده شد. هدف این بود که خانه در نهایت کوتاه بیاید، اما به یک استقبالکنندهٔ خوشبرخورد تبدیل نشود؛ کمی مقاومت بخشی از جذابیت است، اما بحث بیپایان با یک در گاراژ نه.
صدا، تأخیر و دو GPU
خانهٔ تسخیرشده اگر برای غر زدن زیادی معطل کند، هیبتش را از دست میدهد. به همین دلیل خط لوله متنِ قابلخواندن را پیش از کامل شدن کل پاسخ آزاد میکند تا خانه وقتی ادامهٔ جمله هنوز در راه است، حرف زدن را شروع کند. خوشآمدها و جوکهای شکلاتی آماده هم کار را سریعتر میکنند: بانک متن، بار محاسباتی مدل زبانی را کم میکند و ضبطهای ذخیرهشده، سنتز گفتار را دور میزنند.
اعداد منتشرشده اینها هستند: میانهٔ فاصلهٔ پایان گفتار تا پخش صدا با Bolt Q4 و TTS برابر ۱٫۷۰ ثانیه، و برای پاسخهای ذخیرهشده ۰٫۷۲ ثانیه است. یک نکتهٔ فنی هم در محاسبه اثر دارد: تشخیص پایان گفتار فعلاً ۳۰۰ میلیثانیه سکوت را انتظار میکشد.
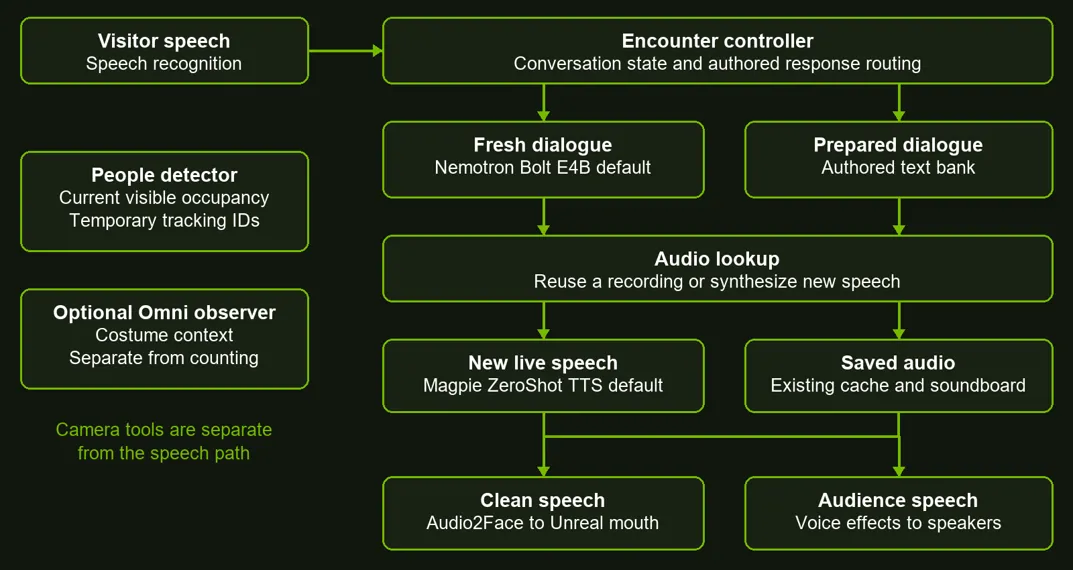
NVIDIA Magpie TTS Zeroshot متن را به انگلیسی بریتانیایی تبدیل میکند. شرطیسازی صدا در این مدل بر پایهٔ یک نمونهٔ مرجع کوتاه است، نه صدایی که از قبل آموزش دیده؛ نمونهٔ سازنده همان شخصیت بداخلاق دزد دریایی را میسازد. خانه هفت حالت احساسی دارد، از غرولند و تهدیدآمیز تا سرخوش و شادمان، و برچسبهای احساسی که قالب پرامپت تعیین میکند و مدل زبانی میدهد، نحوهٔ ادا شدن هر جمله را مشخص میکنند. چون هر احساس به نمونهٔ صوتی ۳ تا ۱۰ ثانیهای جداگانه نیاز دارد، سازنده بخشی با نام «Sample your Voice» را به تب ابزارهای رابط کاربری اضافه کرد تا بتواند هر خط را با بهترین صدای دزد دریایی خوشحال یا عصبانی خودش بخواند و ضبط کند.
مرحلهٔ بعد Audio2Face-3D و صحنهٔ سهبعدی ساختهشده در Unreal Engine است. وزنهای پیشفرض این مدل با صدای تمیز و خنثای مردانه یا زنانه بهتر کار میکنند؛ نه زیادی بم و نه زیادی زیر. سازنده صداهایی بم و شیطانی با اکو و فضای بسته میخواست، اما چون نمونههای صوتی خودش آن سنگینی تئاتری را ندارند، این محدودیت به سود کار تمام شد: Audio2Face-3D گفتار تمیز نمونهها را میگیرد و یک جریان صوتی دوم جلوههای زندهٔ قابلتنظیم را از بلندگوها پخش میکند.
برای روان ماندن همهچیز، کار بین دو پردازندهٔ گرافیکی تقسیم شده است: خط لولهٔ مدل زبانی و صدا روی RTX PRO 6000 Blackwell Max-Q و گرافیک Unreal Engine همراه با Audio2Face-3D روی RTX PRO 4000 Blackwell. به گفتهٔ سازنده، مسئله حافظه نیست، توان محاسباتی است؛ او میخواهد انیمیشن بدون توجه به پردازش خط لولهٔ ایجنت، نرخ فریم ثابتی داشته باشد. برای همزمانی صدا، انیمیشن و جلوهها هم تنظیمی وجود دارد: ۱۰۰ میلیثانیه تأخیر، بافر Audio2Face-3D را جبران میکند.
میز کنترل و حالتهای اجرا
در میانهٔ راه، «کاری کن خانه حرف بزند» به رابطی پر از کنترل تبدیل شد. سازنده میتواند خطوط ذخیرهشده را گوش کند، حالت شروع را تغییر دهد، گفتوگو را دنبال کند، نحوهٔ پردازش صدا را عوض کند و انیمیشن دهان را تنظیم کند. تبها گفتوگوها، انتخاب مدل، ضبطها، پرامپتها، پایش عملکرد و فید دوربینها را پوشش میدهند و یک تابلوی صدا و فیلد دیالوگ دلخواه اجازه میدهد واژهها را در دهان خانه گذاشت. کنترل بارگذاری مدل و نشانگر اتصال Unreal Engine هم هست، چون گاهی مشکل این نیست که هیولا قهر کرده؛ اتصالش قطع شده است.
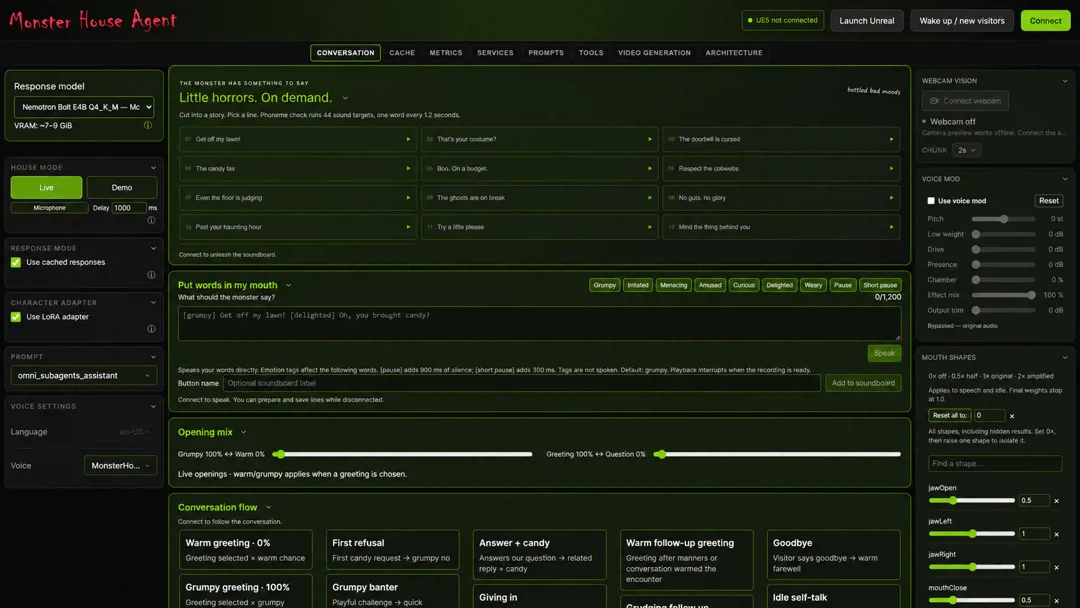
آتش و درخشش هم به بازی وارد شدهاند. قواعد قابلویرایش، نشانههای بصری را به نحوهٔ ادا شدن جمله گره میزنند: نشانههای زنده با گفتار شروع میشوند، در حالی که اجراهای ضبطشده میتوانند از یک خط زمانی ذخیرهشده پیروی کنند. اینطور میشود بدون بازسازی صحنه، حالوهوای خانه را عوض کرد.
- حالت زنده: همان شخصیت trick-or-treat که با بازدیدکنندهها حرف میزند.
- حالت نمایش: خانه را وادار میکند دربارهٔ خودش توضیح بدهد.
- حالت میکروفون: سازنده مستقیم از زبان خانه حرف میزند و تشخیص گفتار، تولید دیالوگ و سنتز صدا را دور میزند؛ صدای تمیز او دهان را حرکت میدهد و مخاطب نسخهٔ پردازششده را میشنود. به شوخی، خانه این را «تسخیر» میداند.
پنج گوسفند مبدل و مسیر ساختن نسخهٔ خودتان
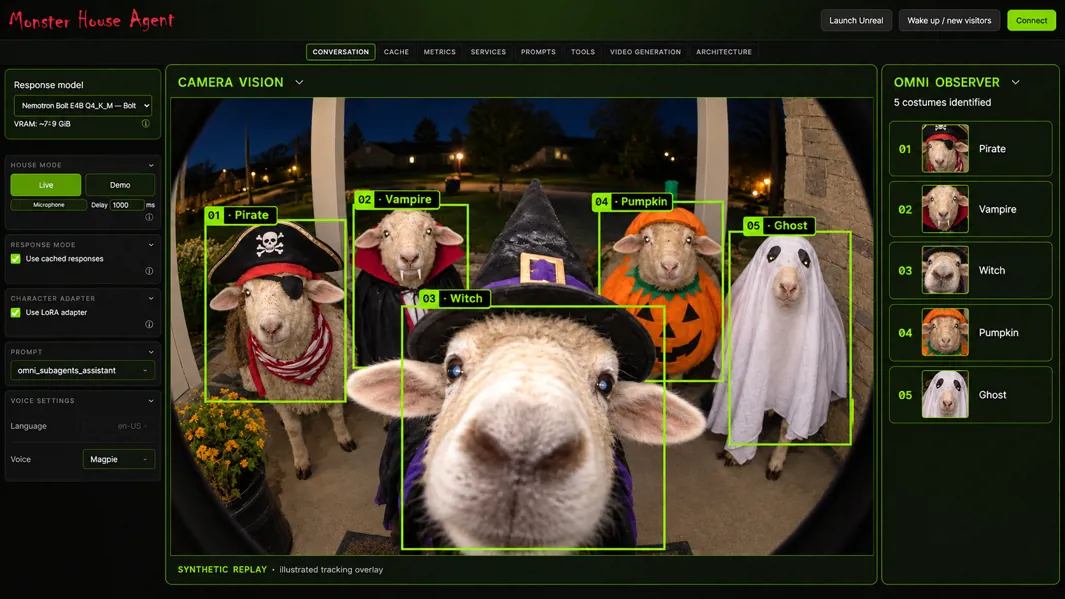
Nemotron 3 Nano Omni یک مدل زبانـبینایی است که به خانه زمینهٔ بصری میدهد. این مدل بهعنوان ناظری اختیاری، تصویر دوربین را تفسیر میکند و لباسهای دیدهشده را توصیف میکند تا شخصیت چیزی مشخص برای واکنش نشان دادن داشته باشد. سازنده برای شمارش و ردیابی افراد حاضر در قاب، سراغ مدلهای شناختهٔ تشخیص شیء و ردیابی یعنی YOLO و ByteTrack رفته است. جدا نگهداشتن این وظایف اجازه میدهد خانه یک گروه را متوجه شود، بدون آنکه لازم باشد Omni هر فریم را روایت کند.
برای یک آزمون بهاندازهٔ کافی پوچ، سازنده ویدیویی از پنج گوسفند مبدل جلوی در را به Omni داد. تحلیل ذخیرهشدهٔ مدل، لباس دزد دریایی، خونآشام، جادوگر، کدوحلوایی و روح را تشخیص داد. اما خود سازنده تأکید میکند که این گوسفندها یک آزمون مصنوعیاند و مدرکی برای یک شب هالووین موفق نیستند؛ گروههای واقعی جلوی در، لباسهای واقعی و نورپردازی شب هنوز آزمایش نشدهاند. تشخیص، خوشآمدگویی خودکار را فعال میکند، اما به گمان او شناسایی لباسهای مد روز و پاسخهای بامزهٔ متناسب ممکن است به آموزش بیشتر نیاز داشته باشد.
کد MonsterHouse برای انتشار بستهبندی نشده، اما همهٔ مدلهای انویدیایی که در آن به کار رفته امروز در دسترساند. مسیری که سازنده پیشنهاد میکند این است:
- با خط لولهٔ صدا شروع کنید: NVIDIA Nemotron Voice Agent را کلون کنید و نمونهٔ Generic Assistant را اجرا کنید تا خط لولهای آبشاری با Nemotron Speech ASR، یک مدل زبانی و Magpie TTS، همراه با تشخیص فعالیت صوتی و مدیریت پایان گفتار داشته باشید.
- Bolt E4B را مغز کار کنید؛ Voice Agent پروفایلهایی از این مدل برای استقرار ابری، سروری و تکGPU دارد و میتوانید اول آن را روی build.nvidia.com امتحان کنید. حالت گفتاری را برای پاسخهای کوتاه و آمادهٔ گفتار انتخاب کنید و استدلال را برای تعاملهای ساده خاموش بگذارید.
- شخصیت بدهید: از یک پرامپت سیستمی و چند دیالوگ نمونه شروع کنید، وضعیت گفتوگو را در برنامهٔ خودتان نگه دارید و اگر پرامپت کافی نبود، با دستور LoRA در NVIDIA NeMo AutoModel یک آداپتر آموزش بدهید.
- صدا بدهید: Magpie TTS Multilingual پیشفرض Voice Agent است و برای شخصیت سفارشی، Magpie TTS Zeroshot با یک نمونهٔ مرجع کوتاه کار میکند. سازنده یادآوری میکند که فقط از صداهایی استفاده کنید که اجازهٔ استفاده از آنها را دارید.
- چهره بدهید: Audio2Face-3D گفتار را به انیمیشن صورت تبدیل میکند؛ به آن گفتار تمیز بدهید و جلوهها را بعد اضافه کنید. اگر چشم هم میخواهید، نمونهٔ Nemotron Omni Assistant Subagents در Voice Agent درک زندهٔ وبکم با Nemotron 3 Nano Omni را اضافه میکند.
یک بانک پاسخ ذخیرهشده و صدای ضبطشده برای پرتکرارترین جملهها هم حتی کندترین هیولا را سریع نشان میدهد. اگر توان محاسباتی محدود است، به گفتهٔ سازنده میتوان نسخهای ساخت که فقط با Nemotron 3 ASR و یک مسیریاب گفتوگوی پایتونی و صداهای ذخیرهشده کار کند؛ یعنی صدها پاسخ را از پیش با خط لولهٔ Bolt E4B و Magpie تولید کرد و بعد در نمایش از حافظه پخش کرد. برای مدلهای گفتاری باز دیگر میتوانید Granite Speech 5.0 را هم ببینید، یا سراغ معماریهایی بروید که چت، تصمیم و گفتار را از یک نقطه پایانی ارائه میدهند، مثل Granite Switch 4.1.
هدف اصلی هنوز محقق نشده است: سازنده امیدوار است روزی بتواند خانه را برای شب هالووین رها کند و با خانوادهاش به دیدن هیولاهای محلهٔ دیگر برود. در آن روز، کودکی با یک خانهٔ بداخلاق روبهرو میشود، کمی مهربانی میکند و کشف میکند که تیرهای کهنه هم نقطهٔ ضعفی دارند — و شکلات میگیرد.
پرسشهای متداول
MonsterHouse از چه مدلهایی استفاده میکند؟
از Nemotron 3 ASR برای شنیدن، Nemotron 3.5 Bolt E4B 4GB برای تولید پاسخ، Magpie TTS Zeroshot برای صدا، Audio2Face-3D برای انیمیشن دهان و بهصورت اختیاری Nemotron 3 Nano Omni برای توصیف لباس بازدیدکنندهها.
تأخیر پاسخ MonsterHouse چقدر است؟
به گزارش سازنده، میانهٔ فاصلهٔ پایان گفتار تا پخش صدا با Bolt Q4 و TTS برابر ۱٫۷۰ ثانیه است و برای پاسخهای ذخیرهشده به ۰٫۷۲ ثانیه میرسد.
چرا سازنده Bolt E4B را انتخاب کرد؟
او بیش از یک دوجین مدل را آزمایش کرد و Bolt E4B را با وجود ردپای کوچکتر از Qwen3 30B-A3B و Qwen 3.6 35B-A3B گزینهٔ مناسبتری برای ایجنت گفتاری محلی دید.
آیا کد MonsterHouse منتشر شده است؟
نه، کد MonsterHouse بستهبندی و منتشر نشده، اما همهٔ مدلهای انویدیایی که در آن به کار رفته امروز در دسترساند.
منبع: Hugging Face