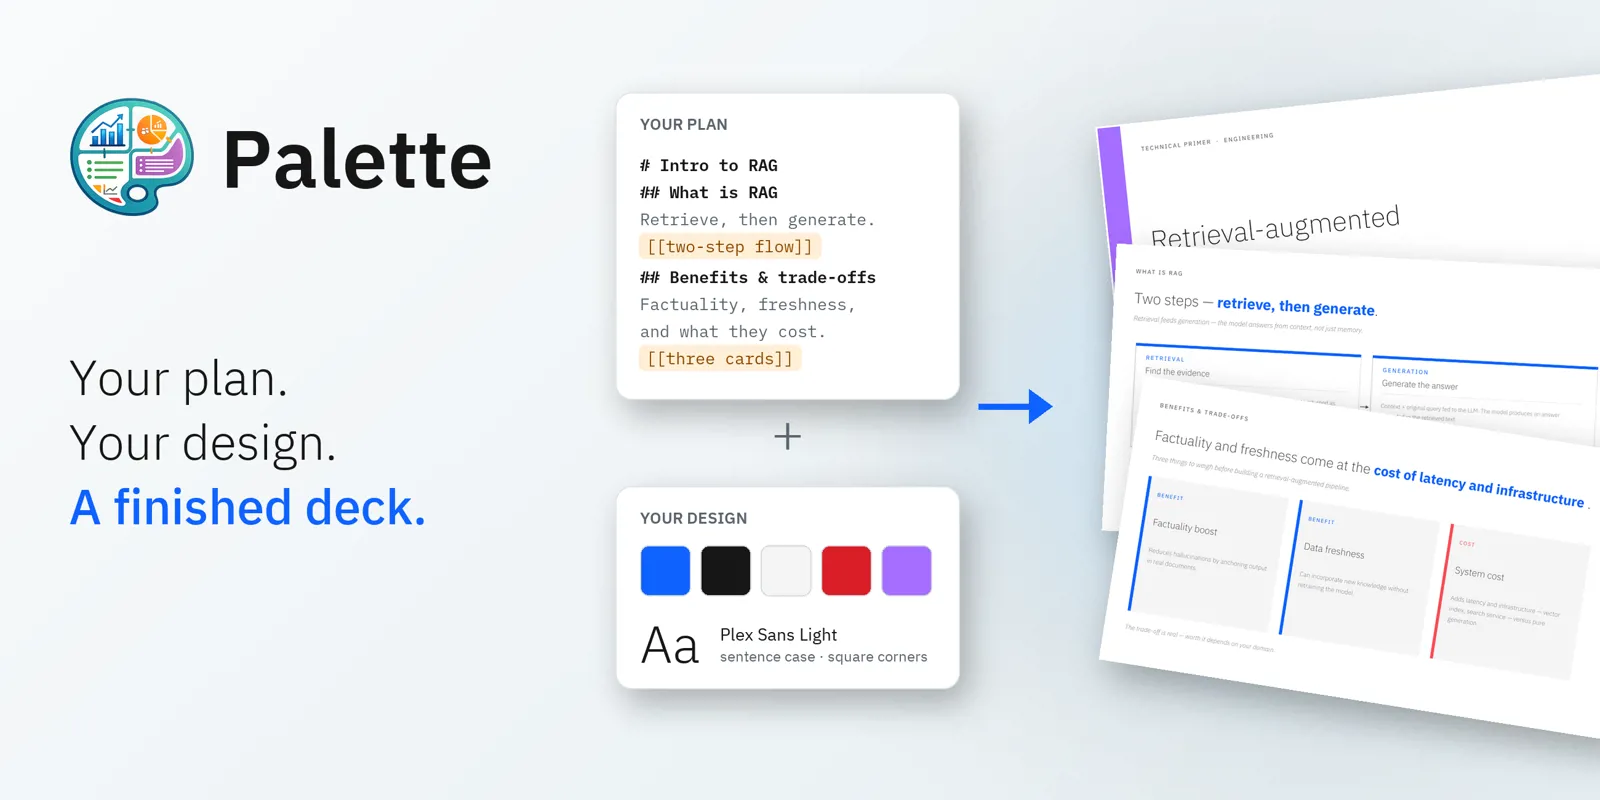
پالت (Palette) یک مدل متنباز ۲۰ میلیارد پارامتری است که برای حل یک مشکل رایج طراحی شده: ساخت ارائههای پاورپوینت که به جای پیروی از سبک پیشفرض مدلهای بزرگ، دقیقاً منطبق بر زبان طراحی و قالب دلخواه شما باشند. این مدل با دادههای مصنوعی آموزش دیده و در برخی حوزههای ارزیابی، با مدلهای پیشرفته موجود رقابت میکند.
چالش ساخت ارائه با مدلهای کوچک
ساخت یک ارائهٔ استاندارد، از مدلهای زبانی کوچک چندین مهارت پیچیده میطلبد که در آنها ضعف دارند. اولاً، مدل باید چیدمان هر اسلاید را بدون دیدن خروجی نهایی و تنها با محاسبات ذهنی طراحی کند. اینکه یک عنوان ۷۵ کاراکتری با فونت ۵۶ پوینت در دو خط جا میشود یا نه، یک محاسبهٔ حسابی است که خطا در آن منجر به همپوشانی المانها یا بیرون زدن متن از اسلاید میشود.
ثانیاً، مدل باید همزمان دو نوع تصمیم بگیرد: تصمیمهای محتوایی و تحریریهای (مثلاً نمایش داده با نمودار یا جدول) و تصمیمهای دقیق هندسی برای جایگذاری. انجام هر دو در یک مرحله و در طول ۱۰ تا ۲۰ اسلاید، کار دشواری است.
مشکل سوم، نبود دادهٔ آموزشی مناسب است. اگرچه ارائههای آمادهٔ زیادی وجود دارند، اما دادهای که فرآیند ساخت، استدلال پشت انتخابهای طراحی و کدی که اسلایدها را تولید کرده، نشان دهد، در دسترس نیست.
معماری دوگانه: طراح و کدنویس
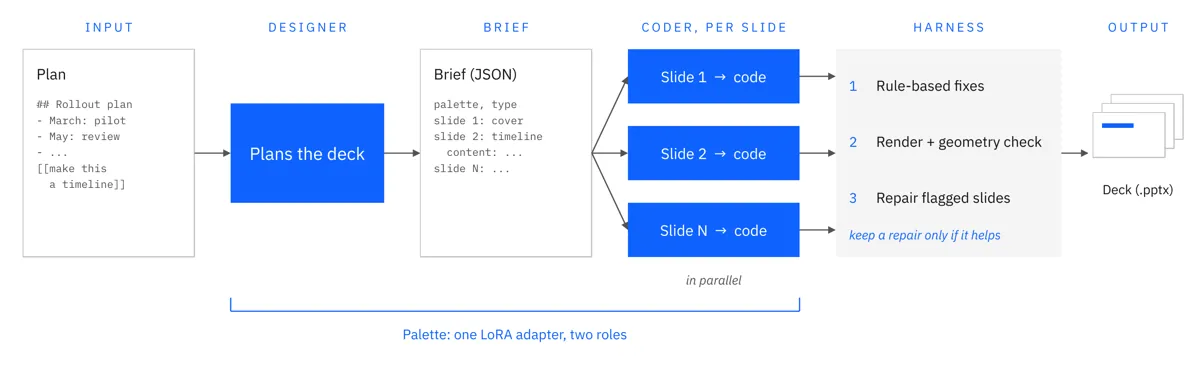
پالت فرآیند ساخت ارائه را شبیه به روش انسانها به دو نقش مجزا تقسیم میکند: یک طراح و یک کدنویس. هر دو نقش توسط یک لورا (LoRA) آداپتور روی یک مدل پایهٔ ۲۰B پیادهسازی شدهاند.
نقش طراح، طرح کلی ارائه (Plan) را میخواند و یک خلاصهٔ ساختاریافته به فرمت JSON تولید میکند. این خلاصه شامل پالت رنگی، سیستم تایپوگرافی و برای هر اسلاید، مشخصات چیدمان، محتوای دقیق و یک استدلال طراحی کوتاه است.
نقش کدنویس، مشخصات یک اسلاید را از این خلاصه میگیرد و کد JavaScript کتابخانهٔ pptxgenjs را برای رسم آن اسلاید مینویسد. کدنویس نیز پیش از کد، استدلال خود را میآورد.
این تفکیک مزایای زیادی دارد. هر نقش روی یک نوع تصمیم تمرکز میکند. خلاصهٔ میانی قابل خواندن و ویرایش است و امکان کنترل دستی یا توسط ایجنت را فراهم میکند. همچنین، از آنجا که زمینهٔ هر اسلاید قبل از مرحلهٔ کدنویسی ثابت شده، میتوان کدنویسی اسلایدها را به صورت موازی انجام داد که سرعت این مرحله را ۶ تا ۷ برابر افزایش میدهد.
برای آموزش از لورا به جای فاینتیونینگ کامل استفاده شد. یک درس کلیدی این بود که نمونههای آموزشی کدنویس حدود ۵ برابر طولانیتر از نمونههای طراح بودند؛ بنابراین برای جلوگیری از آموزش ناکافی طراح، نمونههای آن ۵ برابر بیشتر نمونهگیری شدند.
تولید دادههای مصنوعی و استدلالها
از آنجا که دادهٔ عمومی از این فرآیند وجود نداشت، یک مجموعه داده با کمک یک مدل بزرگ متنباز به عنوان معلم (Teacher) تولید شد. هر ارائه از یک دستورالعمل (Recipe) شروع میشد که ژانر، طول، چیدمانها و هرگونه دستورالعمل کاربری را تعیین میکرد.
حدود ۱۰۰۰ ارائه معادل تقریباً ۱۰٬۰۰۰ اسلاید تولید شد. نکتهٔ کلیدی این بود که هر مثال آموزشی، حاوی استدلال پشت انتخابها نیز بود. این استدلال به صورت یک گزارهٔ ضدواقعی (Counterfactual) نوشته میشد؛ یعنی گزینهٔ ردشده و دلیل رد آن شرح داده میشد تا مدل قاعدهٔ پشت انتخاب را بیاموزد.
برای مثال، استدلال طراح ممکن بود چنین باشد: «درآمد برای چهار فصل، با یک روند صعودی مشخص. من استفاده از جدول را در نظر گرفتم، اما نکتهٔ اصلی این اسلاید نشان دادن روند است، نه ارقام دقیق، بنابراین یک نمودار میلهای آن را در یک نگاه قابل مشاهده میکند.»
استدلال کدنویس نیز بر هندسه متمرکز بود: «عنوان ۶۲ کاراکتر است. با فونت ۴۴ پوینت به سه خط شکسته میشود و با نمودار زیرش برخورد میکند، بنابراین آن را روی ۳۶ پوینت تنظیم کردم که در دو خط جا میشود و فضای کافی بالای نمودار باقی میماند.»
یک حلقهٔ کنترل کیفیت، خروجی مدل معلم را قابل اعتماد میکرد. هر ارائهٔ مصنوعی رندر و توسط یک بررسیکننده (Checker) از نظر همپوشانی و سرریز بررسی میشد. اسلایدهای مشکلدار تعمیر و استدلال آنها بازنویسی میشد. هر اشتباهی که بررسیکننده تشخیص میداد، به یک مثال آموزشی بهتر تبدیل میشد.
مشکل سختتر، حفظ وفاداری به دادهٔ ورودی بود. بدترین حالت، افزودن حقایقی است که در ورودی وجود ندارند. راهحل نهایی، استفاده از ارائههای مرجع در پرمپت مدل معلم بود، نه افزودن قواعد بیشتر. مدل معلم به شدت از این ارائههای مرجع کپی میکرد، در حالی که کمتر از دستورالعملهای متنی پیروی مینمود.
هدایت ارائه با دستورالعملهای ساده
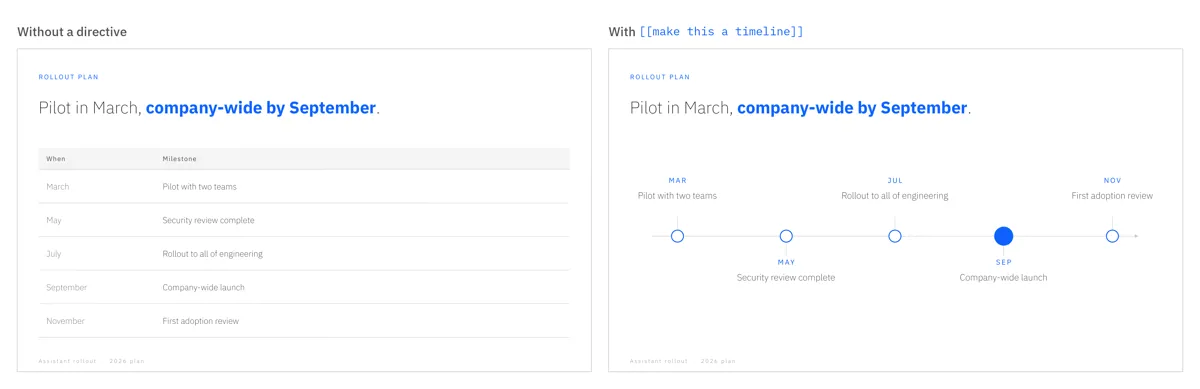
کاربران اغلب میخواهند کنترل دقیقتری روی انتخابهای طراحی داشته باشند. پالت این امکان را با دستورالعملهای کاربر فراهم میکند. این دستورالعملها جملات کوتاهی هستند که مستقیماً در طرح کلی نوشته و داخل دو قلاب [[ ]] قرار میگیرند.
برای مثال: «[[این را به صورت یک جدول زمانی نشان بده]]». طراح این دستورالعمل را در خلاصهٔ خود میگنجاند و کدنویس هنگام رسم اسلاید آن را اجرا میکند.
مدل به این دستورالعملها پاسخ میدهد چون روی دادهای آموزش دیده که شامل آنها بوده است. دستورالعملها در ۱۲ دسته از جمله «چیدمان»، «تن»، «مخاطب»، «ترتیب» و «تأکید» تولید شدهاند و هرکدام به چندین شکل مختلف بیان شدهاند تا مدل قصد کاربر را یاد بگیرد، نه یک عبارت ثابت.
سیستم بازبینی و تعمیر امن
حتی یک مدل خوبآموزشدیده نیز گاهی اسلاید معیوب تولید میکند. بنابراین پالت خروجی خام مدل را مستقیماً برنمیگرداند، بلکه هر ارائه از یک هارنس (Harness) عبور میکند.
اول، قواعد سادهای برخی اشتباهات شناختهشده مثل کد رنگ نادرست را اصلاح میکنند. سپس هر اسلاید رندر و اندازهگیری میشود. یک بررسیکنندهٔ هندسی، متنهای همپوشان، قطعشده یا سرریزکرده را علامتگذاری میکند. اسلایدهای مشکلدار به یک مدل ویرایشگر جداگانه فرستاده میشوند تا کد آن اسلاید بازنویسی شود.
قاعدهٔ کلیدی این است: یک بازنویسی تنها در صورتی حفظ میشود که بررسیکننده تأیید کند اسلاید بهبود یافته است؛ در غیر این صورت نسخهٔ اصلی باقی میماند. این مکانیزم، اجرای هارنس روی همهٔ خروجیها را بیخطر میکند. هارنس میتواند یک اسلاید را تعمیر کند، اما نمیتواند آن را بدتر کند.
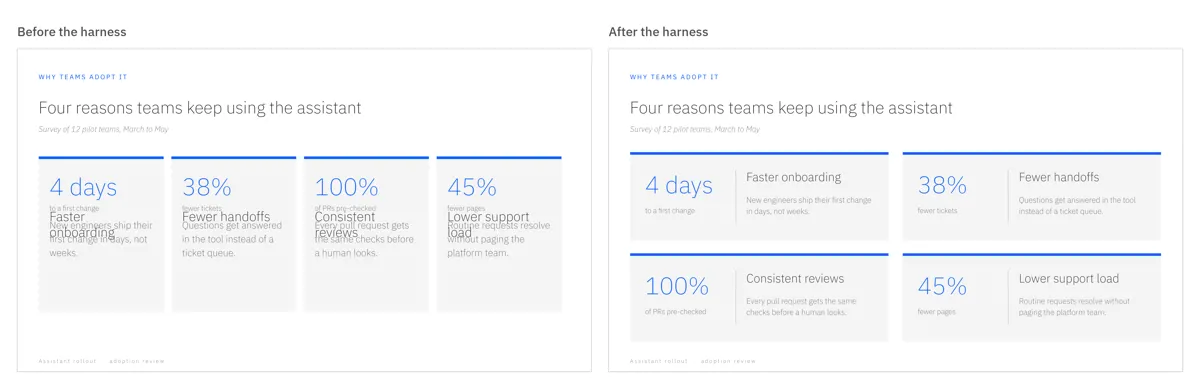
برای سنجش اثر هارنس، هر ارائه در بنچمارک PresentBench یک بار با هارنس و یک بار بدون آن تولید و امتیازدهی شد. در مجموع ۱۳۱ ارائه، هارنس به طور میانگین ۳.۵ امتیاز به نمره اضافه کرد.
ارزیابی بر اساس PresentBench
ارزیابی پالت روی PresentBench انجام شد که ارائههای تولیدشده را بر اساس پنج معیار امتیاز میدهد: اصول پایه، طراحی بصری، کامل بودن، درستی و وفاداری. از آنجا که PresentBench یک سند منبع میدهد نه یک طرح کلی، یک مدل پیشرفتهٔ جداگانه برای هر سند، طرح کلی را تهیه کرد و سپس پالت ارائه را از روی آن طرح ساخت.
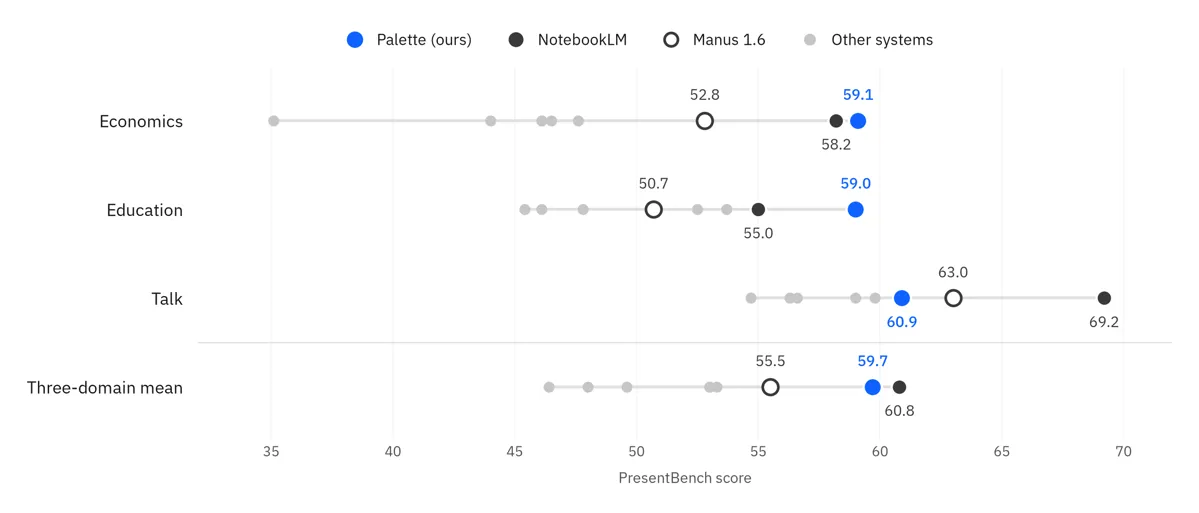
نتایج نشان میدهد پالت در حوزههایی که محتوای ساختاریافته و دقت عددی تعیینکننده است، بهترین عملکرد را دارد و در حوزههای اقتصاد و آموزش رتبهٔ اول را به دست آورد. در حوزهٔ سخنرانی که ارائهها روایی و مبتنی بر گفتار هستند، دو سیستم بسته امتیاز بالاتری گرفتند و پالت سوم شد. در میانگین سه حوزه، پالت با اختلاف ۱.۱ امتیاز پس از NotebookLM (۶۰.۸ در مقابل ۵۹.۷) و بالاتر از بقیهٔ رقبا، به عنوان یک مدل متنباز ۲۰B رتبهٔ دوم را کسب کرد.
شایان ذکر است که PresentBench کیفیت کلی ارائه را میسنجد، اما میزان پیروی از یک زبان طراحی خاص را اندازه نمیگیرد که یک شکاف در معیارهای موجود محسوب میشود.
درسهای کلیدی و آینده
ساخت پالت چند روش مؤثر را آشکار کرد که برای سایر وظایف با خروجی ساختاریافته و قابل بررسی با کد (مثل نمودارها، دیاگرامها یا چیدمان UI) نیز قابل تعمیم هستند:
- استدلال را در داده بگنجانید. آموزشِ «چرایی» یک انتخاب، به همراه گزینهٔ ردشده، بیشتر از خود انتخاب به مدل میآموزد.
- قبل از افزودن قاعده، مثالها را اصلاح کنید. وقتی مدل معلم اشتباه میکرد، افزودن قاعده به پرمپت آن کمکی نمیکرد. مدل معلم به شدت از ارائههای مرجع خود کپی میکرد؛ بنابراین اصلاح مرجع بود که خروجی آن را تغییر میداد.
- تعمیرات را به طور پیشفرض امن کنید. یک اصلاح که تنها هنگام بهبود قابل اندازهگیری حفظ میشود، میتواند روی همهٔ خروجیها اجرا شود.
- اول بررسیکننده را بسازید. این جزء است که دادهها را قابل اعتماد و خروجیها را برای عرضه ایمن میکند.
در آینده، قصد است از سیگنالهای ارزان و قابل تأیید هارنس (مانند عدم همپوشانی) به عنوان پاداش برای آموزش یادگیری تقویتی (مثلاً با روشهایی مانند GRPO) استفاده شود تا مدل از ابتدا این اشتباهات را مرتکب نشود. همچنین، کار روی پشتیبانی بهتر از ارائههای پراز شکل و روشهای سبکتر برای استفاده از قالبهای شخصیشده در دست بررسی است.
پرسشهای متداول
پالت چطور مشکل قالب تکراری ارائههای هوش مصنوعی را حل میکند؟
پالت یک مدل متنباز است که روی دادههای مصنوعی منطبق بر زبان طراحی خاص شما (مثل IBM Design Language) آموزش میبیند و خروجی آن روی زیرساخت خودتان اجرا میشود، بنابراین سبک مخصوص به خود را حفظ میکند.
چرا مدلهای کوچک در ساخت ارائه مشکل دارند؟
چون باید همزمان تصمیمگیری محتوایی و هندسی دقیق بگیرند، بدون آنکه خروجی نهایی را ببینند، و داده آموزشی که فرآیند ساخت و استدلال پشت طراحی را نشان دهد، وجود ندارد.
سیستم بازبینی و تعمیر پالت چطور کار میکند؟
هر ارائه پس از تولید، رندر و از نظر همپوشانی متن، قطع شدن یا بیرون زدن از اسلاید بررسی میشود. اسلایدهای مشکلدار به یک مدل ویرایشگر جداگانه فرستاده و تنها در صورت بهبود تأییدشده، جایگزین میشوند.
منبع: Hugging Face