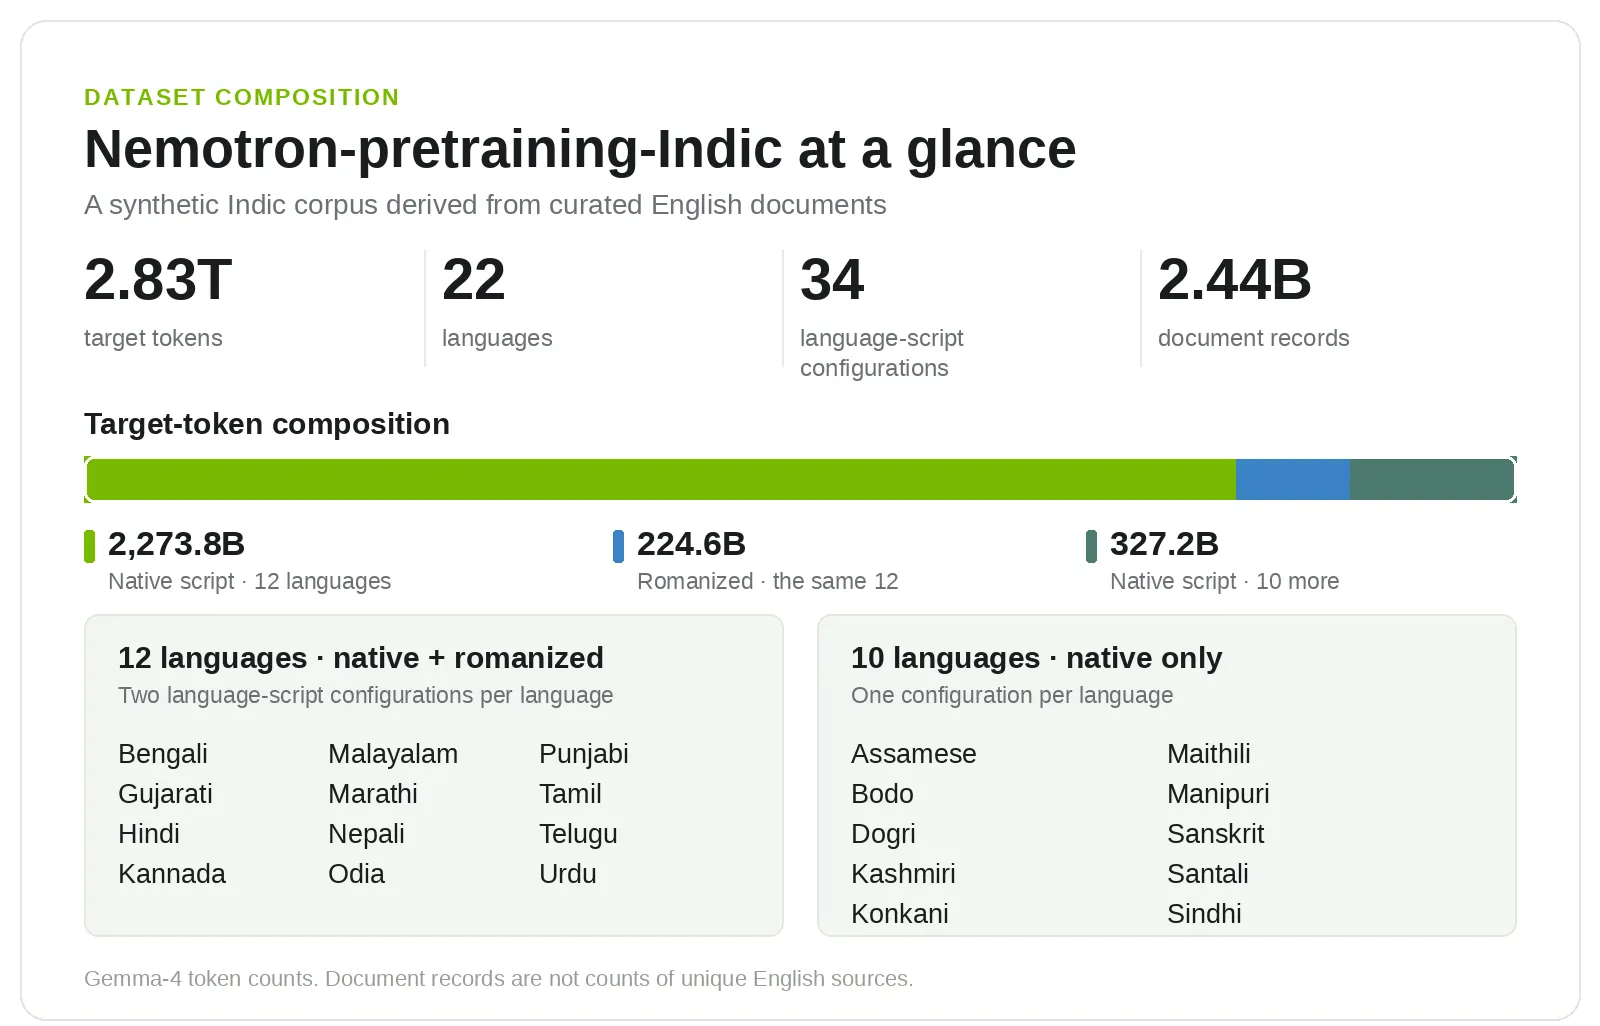
پیکره پیشآموزشی هندی با حدود ۲.۸ تریلیون توکن برای ۲۲ زبان، نتیجه همکاری انویدیا (NVIDIA) با IIT مدرس و آزمایشگاه AI4Bharat است. همراه این داده، یک خط تولید داده متنباز و شتابگرفته با GPU هم منتشر میشود که کل دستور پخت ساخت پیکره را در اختیار تیمهای سازنده مدل میگذارد.
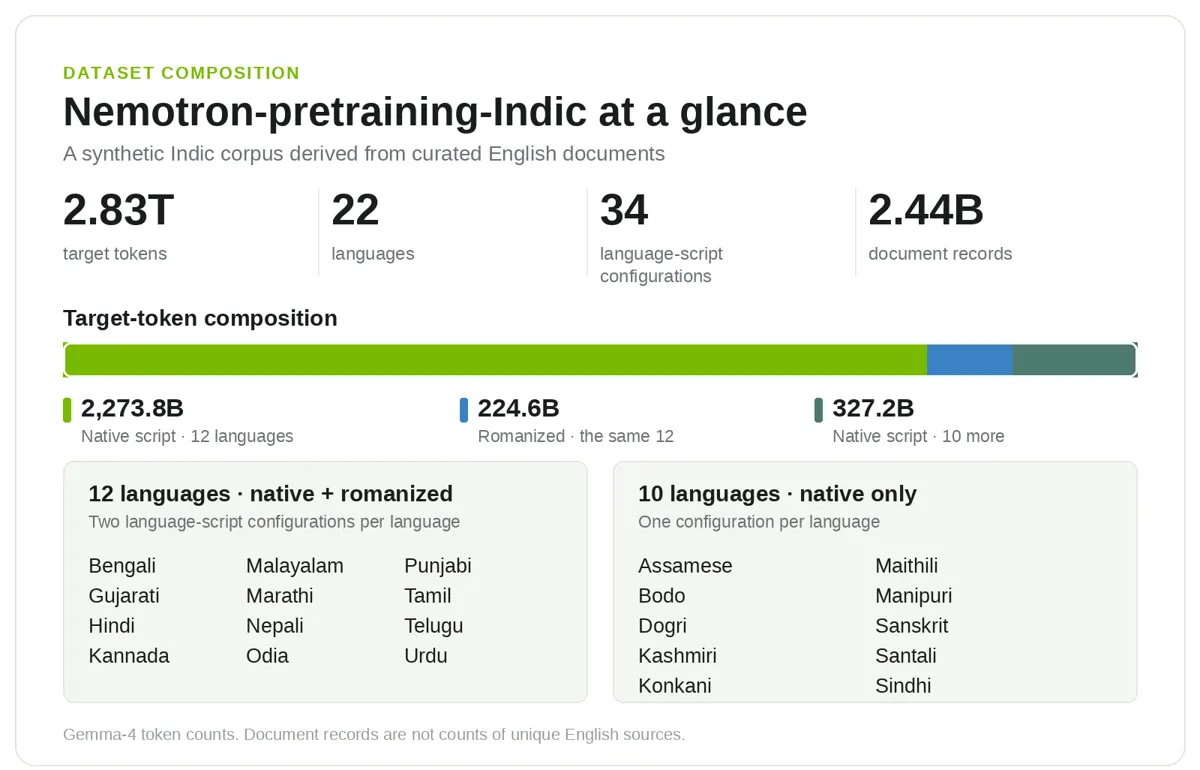
پیکره پیشآموزشی هندی در یک نگاه
نام این مجموعه Nemotron-pretraining-Indic-v1 است و بهزودی منتشر میشود. این ۲۲ زبان، همان زبانهایی هستند که در قانون اساسی هند فهرست شدهاند؛ زبان اول ۹۷ درصد هندیها یا نزدیک به ۱.۲ میلیارد شهروند در سرشماری ۲۰۱۱.
پیکره در همکاری انویدیا با IIT مدرس و آزمایشگاه زبانهای هندی آن، AI4Bharat، ساخته شده است. AI4Bharat پیشتر منابعی مانند Sangraha، پیکره پیشآموزش متنباز برای ۲۲ زبان هندی، را منتشر کرده بود که بخشی از زیربنای پژوهشهای باز در این حوزه شده است.
مسیر تولید فقط خروجی داده نیست؛ پرامپتها، گردشکارهای مدل زبانی و بررسیهای کیفیت هم منتشر میشوند تا توسعهدهندهها بتوانند آنها را با اسناد منبع خودشان تطبیق دهند و داده بیشتری بسازند. هر رکورد به یک سند منبع قابل ردیابی برمیگردد و هر خروجی در برابر ورودیاش بررسی میشود.
میتش کاپرا (Mitesh Khapra) که ریاست AI4Bharat را بر عهده دارد و در فهرست ۲۰۲۵ TIME100 AI قرار گرفته، ریشه مشکل را اینطور توصیف کرده است: داده کافی برای زبانهای هندی در اختیار نداریم. این انتشار پاسخی است به همان کمبود؛ داده بیشتر، بههمراه دستور پختی باز برای تولید داده بیشتر.
ترکیب پیکره: خط بومی و خط رومانیزه
پیکره دو گروه از ترکیبهای زبان و خط دارد. در گروه اول، هر دو حالت خط بومی و رومانیزه وجود دارد؛ در گروه دوم فقط خط بومی.
| گروه | زبانها | نوع داده |
|---|---|---|
| دوازده زبان | بنگالی، گجراتی، هندی، کانادا، مالایالام، مراتی، نپالی، اودیا، پنجابی، تامیل، تلوگو، اردو | خط بومی و رومانیزه |
| ده زبان | آسامی، بودو، دوگری، کشمیری، کونکانی، میتهیلی، مانیپوری، سانسکریت، سانتالی، سندی | فقط خط بومی |
در مجموع ۳۴ ترکیب زبان و خط پوشش داده میشود. در این پیکره، «خط بومی» به نوشتار اشاره دارد و متن همچنان ترجمهای از انگلیسی است؛ در مقابل، «رومانیزه» یعنی متن هندی با الفبای لاتین نوشته شده، نه ترجمه انگلیسی. برای هر یک از دوازده زبان دوخطی، رومانیزهسازی زیرمجموعهای از ترجمههای بومی پذیرفتهشده را پوشش میدهد.
این تفکیک هنگام ساخت ترکیب آموزشی مهم است: رکوردهای بومی و رومانیزه مواجهه با خط متفاوتی میسازند، اما میتوانند محتوای زیربنایی یکسانی را بیان کنند. شمار توکنها پیکره نگهداشتهشده را توصیف میکند — شامل بازنویسیهای پذیرفتهشده — نه بودجه توکن یک اجرای آموزشی را. این شمار به توکنایزر هم وابسته است، پس موجودی پیکره و شمار توکن آموزش را باید جدا خواند.
پیکره ۲٬۶۰۱.۰ میلیارد توکن خط بومی و ۲۲۴.۶ میلیارد توکن رومانیزه دارد؛ شمارشها با توکنایزر Gemma-4 انجام شده است. رکوردهای سند شامل ترجمهها و گونههای خطی از منابع مشترکاند و شمار اسناد انگلیسی یگانه نیستند.
از سند انگلیسی تا داده آموزشی هندی
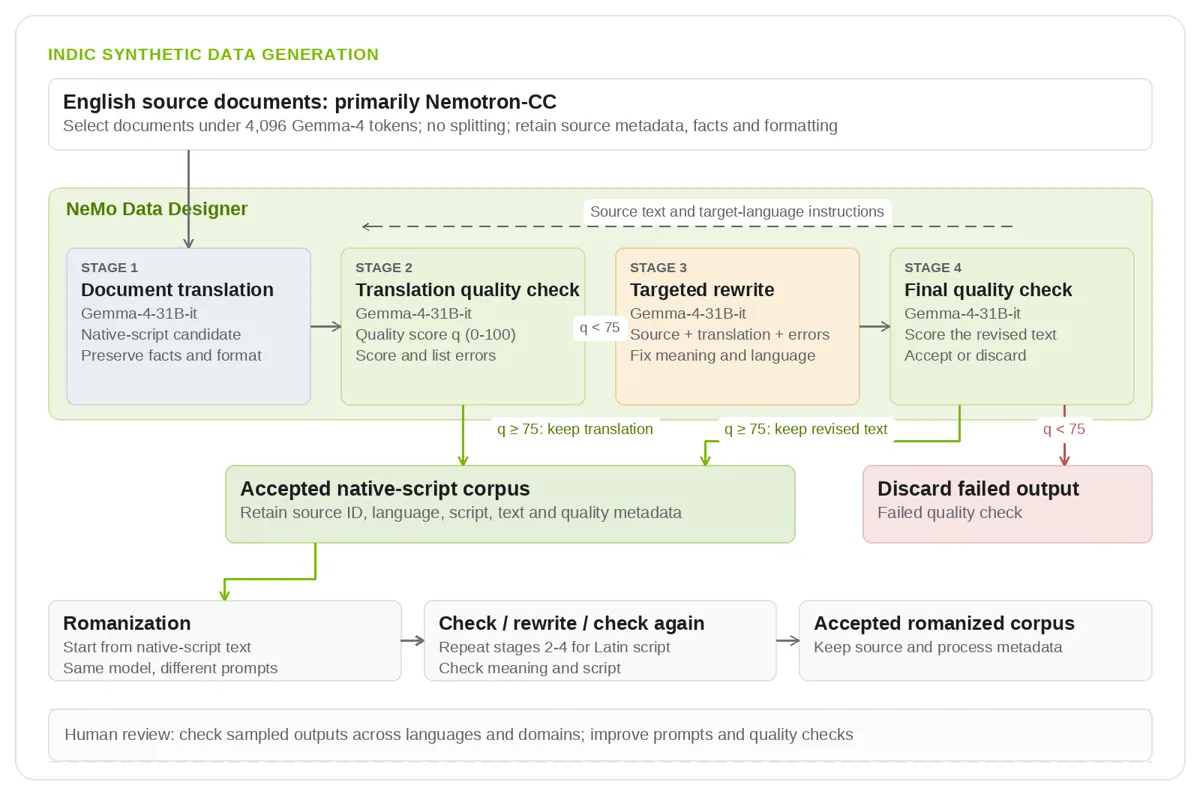
نقطه شروع، اسناد ۱۵ زیرمجموعه از Nemotron-CC-v2 است که متن وب، پرسشوپاسخ، ریاضیات، کد و محتوای تخصصی دیگر را در بر میگیرد. اجرای ترجمه، بررسی کیفیت و ترمیم هدفمند با نِمو دیتا دِیزاینر (NeMo Data Designer)، چارچوب متنباز انویدیا برای تولید داده ترکیبی، انجام میشود. در تمام مسیر، شناسه هر سند نگه داشته میشود تا خروجی به سند اصلی برگردد.
مسیر دوازدهزبانه
در این مسیر، اسناد بهطور کامل ترجمه میشوند تا مدل بتواند از بافت سراسر پاراگرافها، جدولها و معادلات استفاده کند. برای انتخاب مدل، Gemma-4-31B-it روی اسناد کامل با مدلهای دیگر مقایسه شد و کیفیت ترجمه و حفظ محتوای فنی سنجیده شد. پرامپتها میان متنی که باید ترجمه شود و محتوایی که باید دستنخورده بماند — کد، معادلات، نشانیها و قالببندی — تفکیک قائل میشوند.
بعد از ترجمه، همان مدل هر خروجی را در برابر منبع انگلیسی ارزیابی میکند. معیاری الهامگرفته از معیارهای کیفیت چندبعدی (MQM)، چارچوبی باز برای دستهبندی خطاهای ترجمه بر پایه نوع و شدت، معنا، روانی، اصطلاحشناسی، سبک و قالببندی را پوشش میدهد. فقط خروجیهایی با امتیاز دستکم ۷۵ از ۱۰۰ نگه داشته میشوند؛ این عدد امتیاز معیار است، نه درصد دقت. خروجیهای ضعیفتر با راهنمایی بازخورد ارزیابی ترمیم و دوباره سنجیده میشوند. این فرایند ۴۳۸.۴ میلیارد توکن در داده بومی و رومانیزه بازیابی کرد که در جمع کل پیکره لحاظ شده است.
ترجمههای بومی پذیرفتهشده نقطه شروع داده رومانیزه هم هستند: زیرمجموعهای از آنها به خط لاتین تبدیل و هر نتیجه در برابر ورودی بومیاش بررسی میشود. در مقایسه انسانی اولیه، این روش دومرحلهای افزودههای توهمی کمتر و انگلیسی باقیمانده کمتری نسبت به تولید مستقیم متن رومانیزه از انگلیسی داشت.
مسیر دهزبانه
برای ده زبان دیگر، گردشکار برای حل مشکلات کیفیت اسناد بلند و پایداری خط تغییر کرده است. ترجمه با ایندیک ترنسلیت (Indic Translate) انجام میشود؛ مدل ترجمه سطح سند برای انگلیسی و ۲۲ زبان هندی از بودهان ایآی (Bodhan AI)، مرکز غیرانتفاعی هوش مصنوعی در آموزش که در IIT مدرس رشد کرده است. سپس Gemma-4-31B-it هر ترجمه را در برابر منبع انگلیسیاش میسنجد. در هشت زبان، رویکرد سند کامل حفظ میشود؛ برای اسناد بلندتر سانتالی، پنجرههای همپوشان ترجمه و سند بازسازی میشود و برای مانیپوری، متن نخست به خط بنگالی و سپس به میتی مایک، خط بومی این زبان، تبدیل میشود. این مسیرها فقط خروجی با امتیاز دستکم ۷۵ را نگه میدارند، بازنویسی بر پایه بازخورد ندارند و تنها داده خط بومی تولید میکنند.
پیشآموزش پیوسته هندی چه چیزی را تغییر داد؟
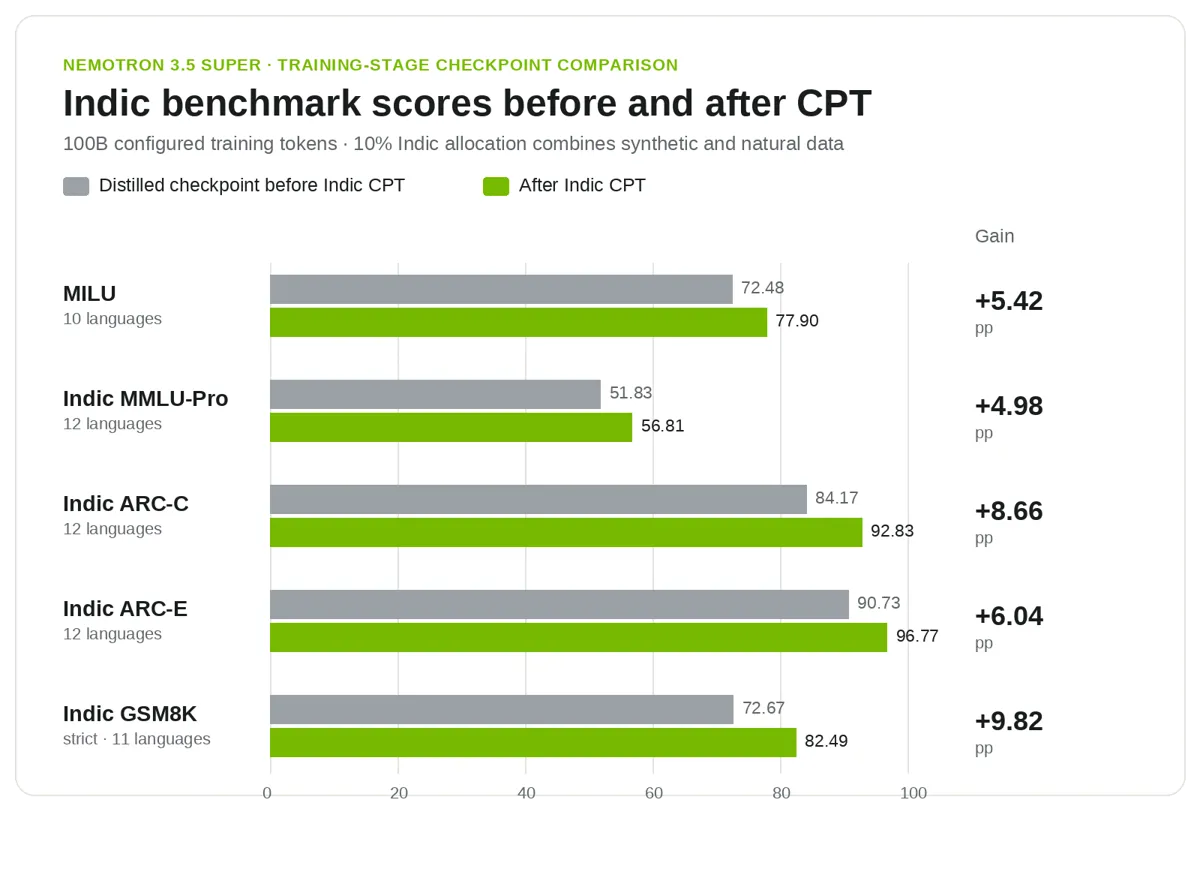
گزارش فنی Nemotron 3.5 Super VL دو نقطه بررسی را مقایسه میکند: وزنهای درست پیش از مرحله پیشآموزش پیوسته (CPT) هندی و وزنهای پس از آن. بودجه تعیینشده ۱۰۰ میلیارد توکن آموزشی بود که ۱۰ درصد آن، یعنی ۱۰ میلیارد توکن، به ترکیبی از متن هندی ترکیبی و طبیعی اختصاص یافت. ۹۰ درصد باقیمانده نسبتهای ترکیب آموزشی پیشین را حفظ کرد.
امتیازها در هر پنج بنچمارک گزارششده دانش و استدلال هندی افزایش یافت: MILU، Indic MMLU-Pro، Indic ARC-Challenge، Indic ARC-Easy و Indic GSM8K. دامنه این رشد بین ۴.۹۸ تا ۹.۸۲ واحد درصد بود. این مقایسه تغییر در یک مرحله آموزشی را نشان میدهد که داده ترکیبی و طبیعی هندی را با هم ترکیب میکند، نه سهم جداگانه پیکره ترکیبی. پوشش زبانها در هر بنچمارک متفاوت است و ارزیابی GSM8K زبان اودیا را کنار گذاشته، چون از محدودیت بافت سرویسدهی فراتر میرفت.
گزارش همراه این پیکره، ترکیب منابع، اندازه استخر داده ترکیبی و پوشش خط را با داده پذیرفتهشده در گذر اول برای گروه دوازدهزبانه بررسی میکند. ارزیابی پیکره کامل، شامل بازنویسیهای بازیابیشده و ده زبان دیگر، گام بعدی این مطالعات کنترلشده است.
مقایسه نسلها: Nemotron 3.5 Super VL و Nemotron 3 Super
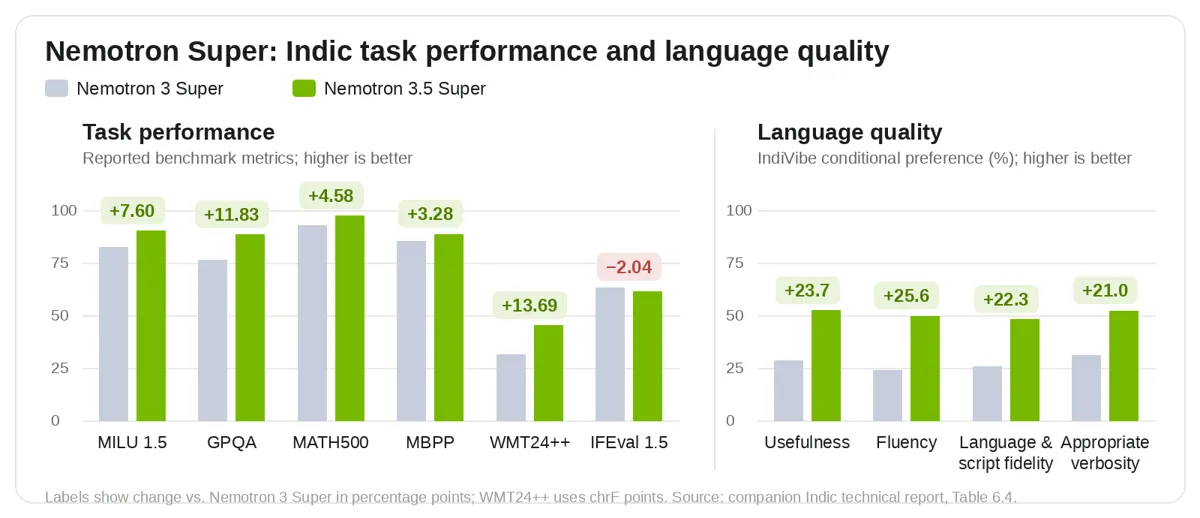
فراتر از نتایج مرحله پیشآموزش پیوسته، مدل منتشرشده چگونه با نسل پیشین مقایسه میشود؟ Nemotron 3.5 Super VL در پنج بنچمارک از شش بنچمارک وظیفهمحور نمایشدادهشده امتیاز بالاتری گرفت؛ این بنچمارکها دانش، استدلال، ریاضیات، کد و ترجمه را پوشش میدهند. در پیروی از دستور روی IFEval 1.5 افت ۲.۰۴ واحدی دیده شد. مدل در هر چهار بُعد IndiVibe هم بهتر شد: سودمندی، روانی، وفاداری زبان و خط، و میزان مناسب تفصیل. IndiVibe بنچمارک باز ساروام ایآی (Sarvam AI) برای پرامپتهای سبک دستیار در زبانهای هندی است.
این نتایج کل مسیر آموزش مدل منتشرشده، شامل پیشآموزش پیوسته هندی و پسآموزش، را بازتاب میدهد. امتیازهای IndiVibe مقدماتیاند و نرخ برد رودرروی مستقیم نیستند؛ برچسبها تغییر بر حسب واحد درصد را نشان میدهند، جز WMT24++ که با واحد chrF سنجیده میشود.
شروع کار با پیکره و تطبیق دستور پخت
نقطه شروع منطقی، همان زبانها و خطهایی است که مدل شما به آنها نیاز دارد. پیش از آموزش، یک نمونه را بررسی کنید و کارت مجموعهداده و مجوز آن را بخوانید. ترکیبها با برچسبهای زبان، خط و منطقه نامگذاری میشوند: برای نمونه hi-Deva-IN هندی در خط دواناگری و hi-Latn-IN هندی رومانیزه را نشان میدهد.
کتابخانه Datasets در هاگینگ فیس از جریانسازی پشتیبانی میکند، پس میتوان رکوردها را بدون دانلود کل پیکره بررسی کرد. پس از انتشار، یک نسخه مشخص از مجموعهداده را برای آزمایشهای تکرارپذیر پین کنید. برای نخستین مطالعه آموزشی، ترکیبها را با بودجه توکن ثابت مقایسه کنید و سهم داده طبیعی/ترکیبی و بومی/رومانیزه را ثبت کنید. نتایج هر زبان را در کنار حفظ توانایی انگلیسی و کیفیت زبان و خط پیگیری کنید و هنگام ساخت تقسیمهای نگهداشتهشده، رکوردهای برگرفته از منبع یکسان در زبانها و خطهای مختلف را در نظر بگیرید.
برای دستور پخت کاملتر میتوان این پیکره را با داده پسآموزشی نِمِترون جفت کرد. برای داده ترکیبی ویژه هند هم میتوان Nemotron-Personas-India را بهعنوان بذر به NeMo Data Designer داد؛ مجموعهای از شخصیتهای ساختگی به انگلیسی و هندی که بر توزیعهای واقعی هند بنا شدهاند. افزونه متنباز Nemotron Bharat برای NeMo Data Designer هم پرامپتهای ترجمه و ارزیابی، بازنویسی اختیاری بر پایه بازخورد، پنجرهبندی اسناد و پشتیبانی تغییر خط را فراهم میکند.
توصیه عملی این است که با نمونه کوچکی از اسناد خودتان شروع کنید، کیفیت ترجمه و حفظ کد و ریاضیات و قالببندی را بررسی کنید و پیش از بزرگکردن مقیاس، پرامپتها و بررسیها را با بازبینهای بومی زبان اصلاح کنید. تولید و پذیرش در پیکره دو گام جدا هستند: افزونه نامزدها و امتیازها را برمیگرداند و این سیاست پالایش شماست که تعیین میکند چه رکوردی وارد پیکره آموزشی شود.
این مسیر بخشی از موج بزرگتری است که در آن شرکتهای فناوری، از زیرساخت تا داده، خود را برای عصر هوش مصنوعی بازآرایی میکنند؛ روندی که مدیرعامل انویدیا هم به آن اشاره کرده است. در همین حال، انتشار مدلها و دادههای باز، مانند Muse Spark Open از متا، نشان میدهد رقابت بر سر منابع آموزشی چندزبانه جدیتر شده است.
دامنه و محدودیتها
ترجمه دسترسی به مواد منبع را گستردهتر میکند، اما جای متن اصالتاً نوشتهشده به زبانهای هندی را نمیگیرد و پوشش دانش و فرهنگ محلی را تضمین نمیکند. توصیه سازندگان، ترکیب این پیکره با متن طبیعی هندی با منبع مناسب و ارزیابی ترکیب حاصل برای کاربرد مورد نظر است.
ارزیابی کیفیت عمدتاً خودکار است و با بازبینی انسانی نمونهای تکمیل میشود که پوشش آن بین زبانها متفاوت است. در گردشکار دوازدهزبانه، همان مدل مترجم نقش داور را هم بازی میکند. متن نگهداشتهشده همچنان میتواند خطا داشته باشد و مسیر دهزبانه به اعتبارسنجی گستردهتر توسط گویشوران بومی نیاز دارد. بررسی شناسه منبع، رکوردهای تکراری پردازشی را حذف میکند، اما حذف تکرار معنایی محتوای مشابه نیست.
در کنار پیکره، AI4Bharat در IIT مدرس با پشتیبانی انویدیا مجموعه Indic-LLM-Eval-Suite را میسازد؛ مجموعهای باز و در حال تکامل از بنچمارکها برای توانمندیهای مدلهای هندی که هم عملکرد وظیفهمحور و هم کیفیت زبان را میسنجد.
پرسشهای متداول
پیکره Nemotron-pretraining-Indic-v1 چند توکن و چند زبان را پوشش میدهد؟
حدود ۲.۸ تریلیون توکن برای ۲۲ زبان هندی؛ شامل ۲٬۶۰۱.۰ میلیارد توکن خط بومی و ۲۲۴.۶ میلیارد توکن رومانیزه که با توکنایزر Gemma-4 شمرده شدهاند.
تفاوت داده خط بومی و رومانیزه در این پیکره چیست؟
خط بومی به نوشتار بومی زبان اشاره دارد، هرچند متن از انگلیسی ترجمه شده است. رومانیزه یعنی متن هندی با الفبای لاتین نوشته شده، نه ترجمه انگلیسی.
ترجمهها با چه حداقلی از کیفیت پذیرفته میشوند؟
فقط خروجیهایی که در معیاری الهامگرفته از MQM امتیاز دستکم ۷۵ از ۱۰۰ بگیرند. خروجیهای ضعیفتر بر پایه بازخورد ارزیابی ترمیم و دوباره ارزیابی میشوند.
پیشآموزش پیوسته هندی چه تأثیری بر Nemotron 3.5 Super VL داشت؟
امتیاز در هر پنج بنچمارک دانش و استدلال هندی افزایش یافت؛ رشد گزارششده بین ۴.۹۸ تا ۹.۸۲ واحد درصد است.
منبع: Hugging Face



