مدل Dharma Field Extractor با ۲ میلیارد پارامتر، فیلدهای دقیق درخواستی شما را از هر نوع سندی — از فاکتور و قرارداد تا فرم و شناسنامه — استخراج کرده و بهصورت JSON ساختاریافته تحویل میدهد. این مدل تخصصی در یک آزمون معیار، از قدرتمندترین مدلهای زبانی عمومی پیشی گرفته و در عین حال هزینه اجرای بهمراتب کمتری دارد.
مدلی برای استخراج ساختاریافته، نه متن خام
پس از عرضه مدل تخصصی DharmaOCR-LITE برای تشخیص متن (OCR) در انواع اسناد، حالا نیاز دیگری مطرح میشود: گاهی شما نه متن کامل صفحه، بلکه فیلدهای خاصی از سند را میخواهید تا مستقیماً وارد سیستم پاییندستی شود. مثلاً شماره فاکتور، تاریخ سررسید و مبلغ کل از یک فاکتور، یا نام بیمار و نوع آزمایش از یک درخواست پزشکی.
مدلهای عمومی بزرگ (LLM) میتوانند با پرامپتینگ دقیق این کار را انجام دهند، اما با قیمت و تاخیر APIهای مرزی، این راهحلی پرهزینه برای مسئلهای کاملاً تعریفشده است. Dharma Field Extractor برای حل همین مشکل ساخته شده است.
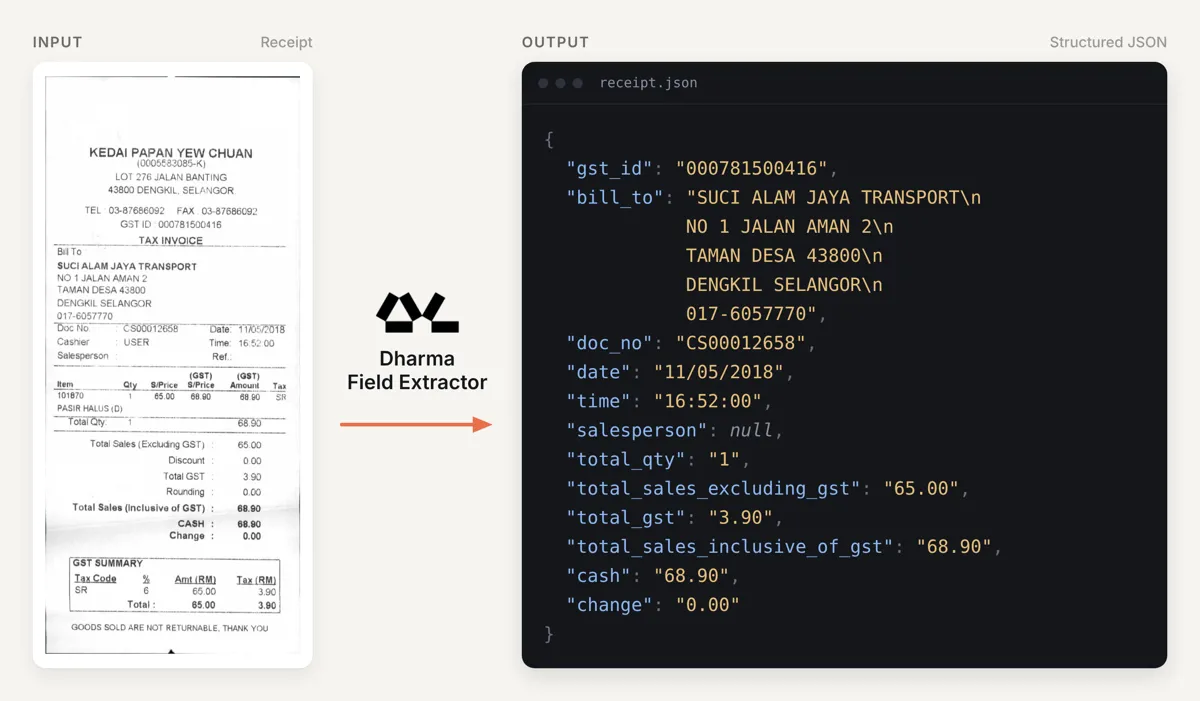
دو حالت درخواست: باز و مبتنی بر اسکیما
این مدل یک تصویر سند و یک درخواست دریافت میکند و خروجی ساختاریافته JSON تحویل میدهد. دو حالت اصلی برای درخواست وجود دارد:
درخواست باز (بدون اسکیما)
هیچ قالبی ارائه نمیشود. مدل صفحه را میخواند و با توجه به上下文 و چیدمان، بخشهایی از سند که فیلد ساختاریافته هستند (مانند یک برچسب به دنبال یک مقدار، یا یک جدول با ردیف سرستون) را شناسایی میکند. سپس تمامی موارد یافتشده را بهصورت جفتهای کلید-مقدار برمیگرداند. این حالت زمانی مفید است که نمیدانید سند حاوی چه اطلاعاتی است.
درخواست مبتنی بر اسکیما
شما شکل دقیق خروجی مورد نظر را، فیلد به فیلد، با نوع هر یک (رشته، عدد یا بولین) و تحت کلیدهایی که سیستم شما از قبل استفاده میکند، مشخص میکنید. مدل دقیقاً فیلدهای درخواستی را پر میکند. اگر فیلدی در سند وجود نداشته باشد، مقدار null برمیگرداند و برای آن مقداری جعل نمیکند. این حالت زمانی ضروری است که خروجی باید با قالبی که جای دیگری وجود دارد مطابقت داشته باشد.
در هر دو حالت، خروجی JSON است: فیلدها بهعنوان کلید، مقادیر با نوع درخواستی، و null برای مواردی که سند فاقد آنهاست.
آموزش روی ترکیبی از دادههای چنددامنه و چندزبانه
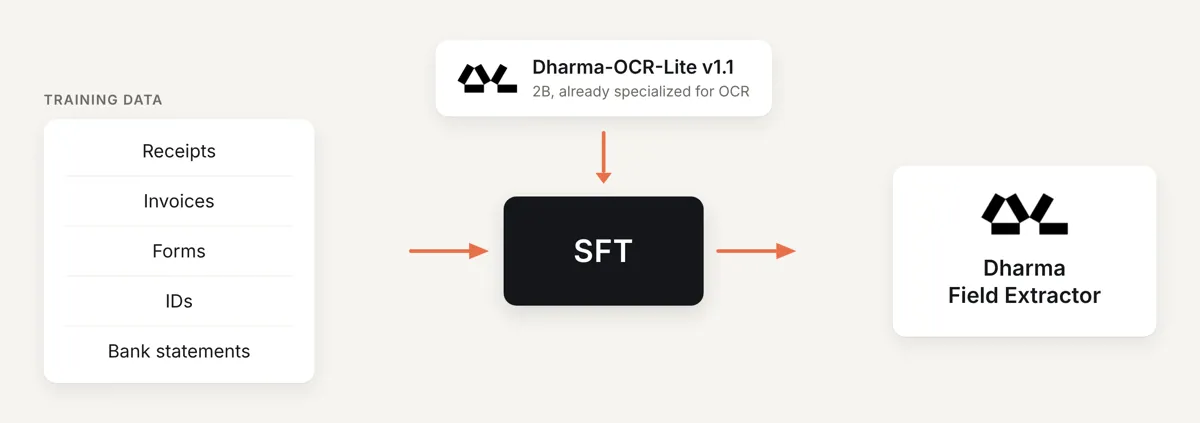
مدل پایه، نسخه ۱.۱ از DharmaOCR-LITE با ۲ میلیارد پارامتر است که برای OCR بهینه شده. بر روی این چکپوینت، یک آداپتور LoRA روی ۴۳,۳۸۴ نمونه آموزشی که هر دو حالت درخواست را پوشش میدهند، آموزش داده شده است.
دادههای آموزش در سه جریان سازماندهی شدهاند:
- دادههای انگلیسی چنددامنه: اسناد متنوع جمعآوریشده از وب عمومی.
- دادههای دامنه برزیلی: اسناد واقعی برزیلی (به زبان پرتغالی) که بهصورت داخلی تهیه شدهاند.
- دادههای چندزبانه: سهم کوچکی که زبانهای اروپایی و آسیایی دیگر را برای تعمیم بهتر پوشش میدهد.
همه این جریانها در سطح فیلد حاشیهنویسی شدهاند و ترکیب آنها عمداً چنددامنه است: شامل رسید، فاکتور تجاری، فرم، صورتحساب بانکی، مدارک شناسایی و اسناد مصنوعی میشود.
برتری در کیفیت و هزینه در بنچمارک
یک بنچمارک جامع روی ۵۴۶ سند و در سه سناریوی درخواست (استخراج باز، اسکیما جزئی و اسکیما با فیلدهای ناموجود عمدی) اجرا شد. امتیاز بر اساس F1 در سطح فیلد، شباهت لوناشتاین روی مقادیر منطبق و سهم خروجیهای معتبر JSON محاسبه شد.
این بنچمارک روی چهار پیکربندی از مدلهای عمومی مرزی نیز اجرا شد.
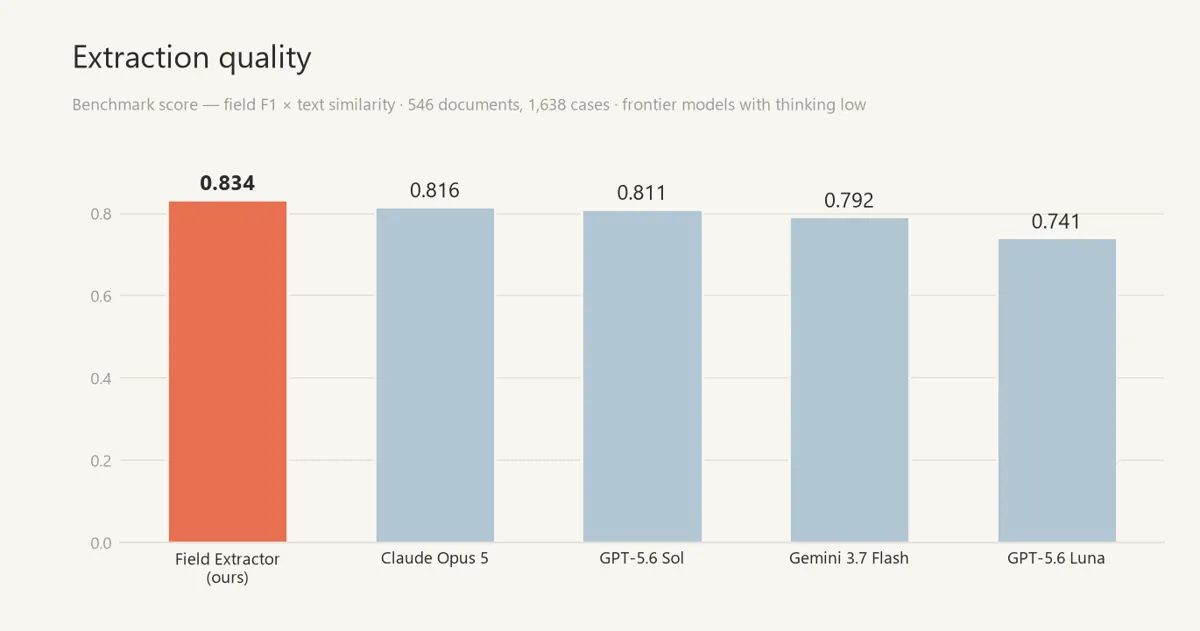
در مقایسه با مدلهای عمومی، شکاف کیفیت از ۱.۸ امتیاز (Claude Opus 5، نزدیکترین) تا ۹.۳ امتیاز (GPT-5.6 Luna، بیشترین) متغیر بود.
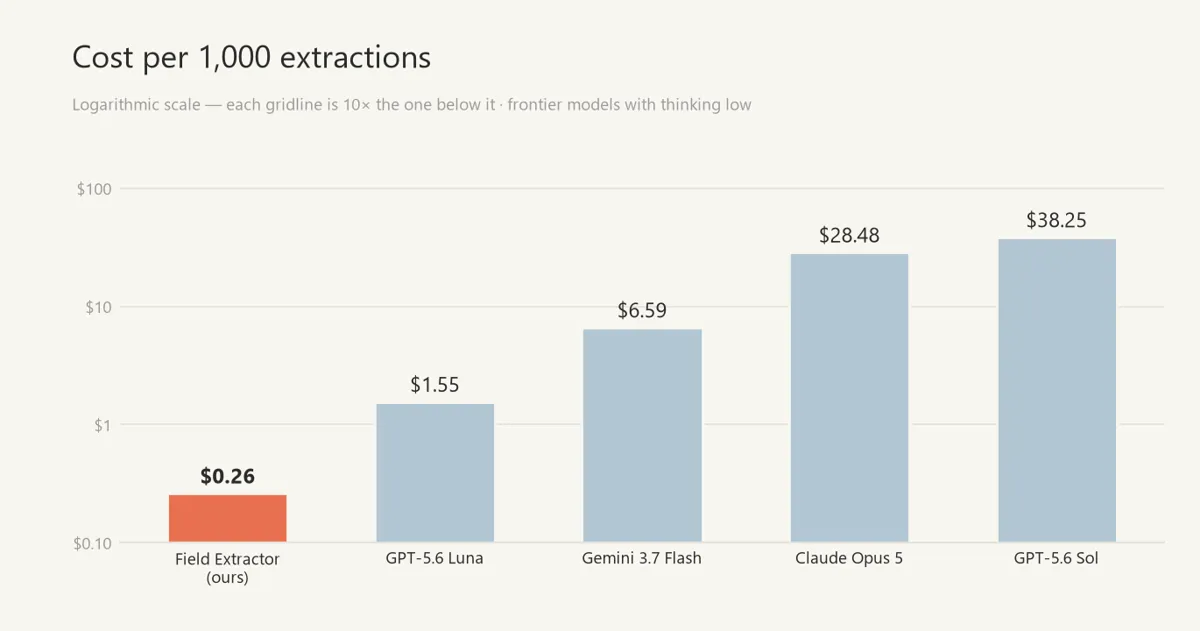
از نظر هزینه، اجرای خودمیزبانی این مدل روی یک کارت گرافیک L40S، بین ۶ تا ۱۴۷ برابر ارزانتر از استفاده از APIهای تجاری مدلهای مرزی برآورد شده است. این مقایسه نشان میدهد یک مدل زبانی کوچک ویژه (SSLM) که روی زیرساخت خودتان اجرا میشود، میتواند جایگزین واقعیای برای APIهای مرزی باشد.
آزمون تعمیم روی دادههای دیدهنشده
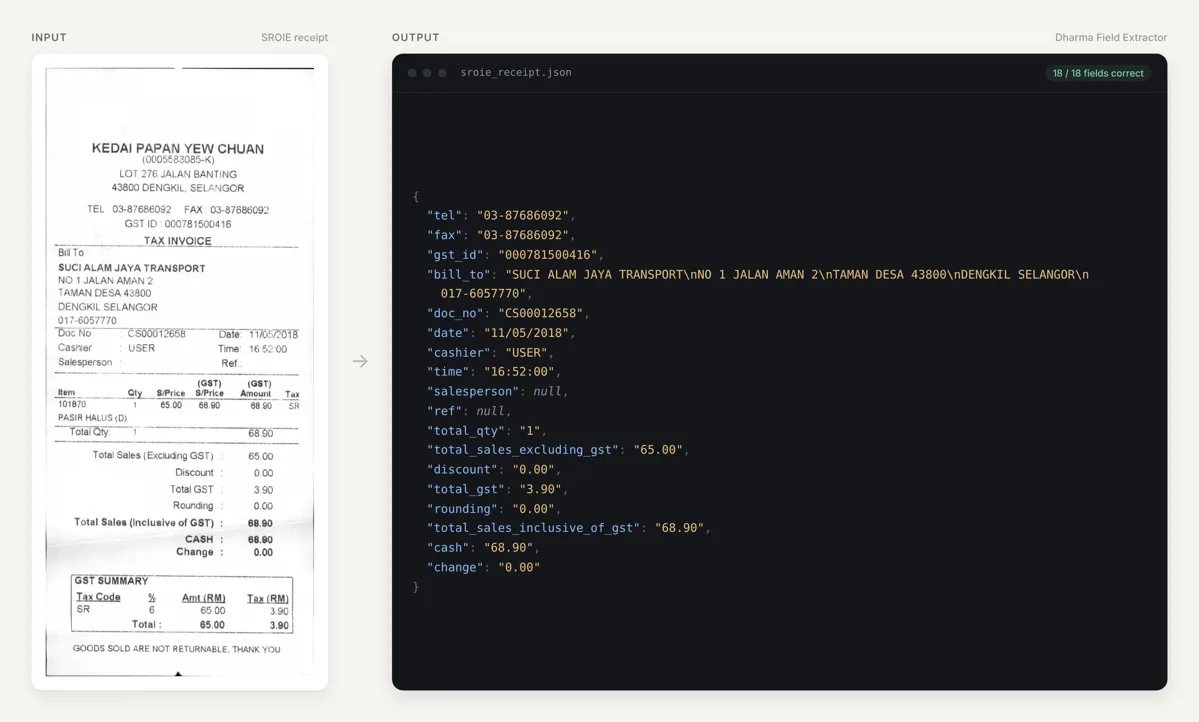
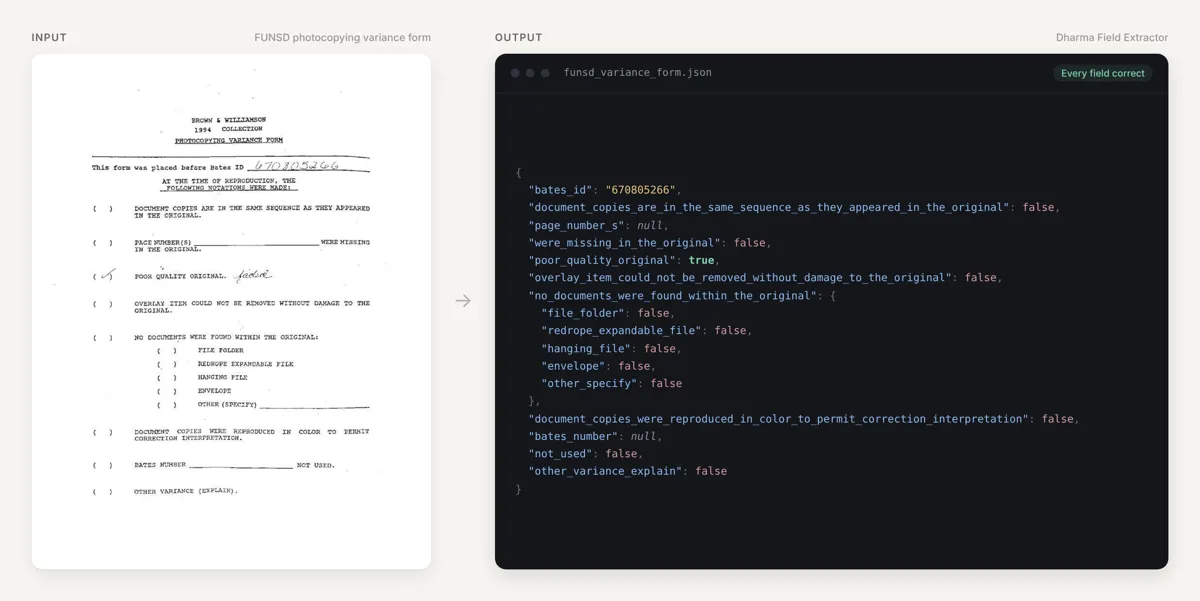
دو مجموعه داده عمومی SROIE و FUNSD که در آموزش استفاده نشده بودند، در بنچمارک گنجانده شدند.
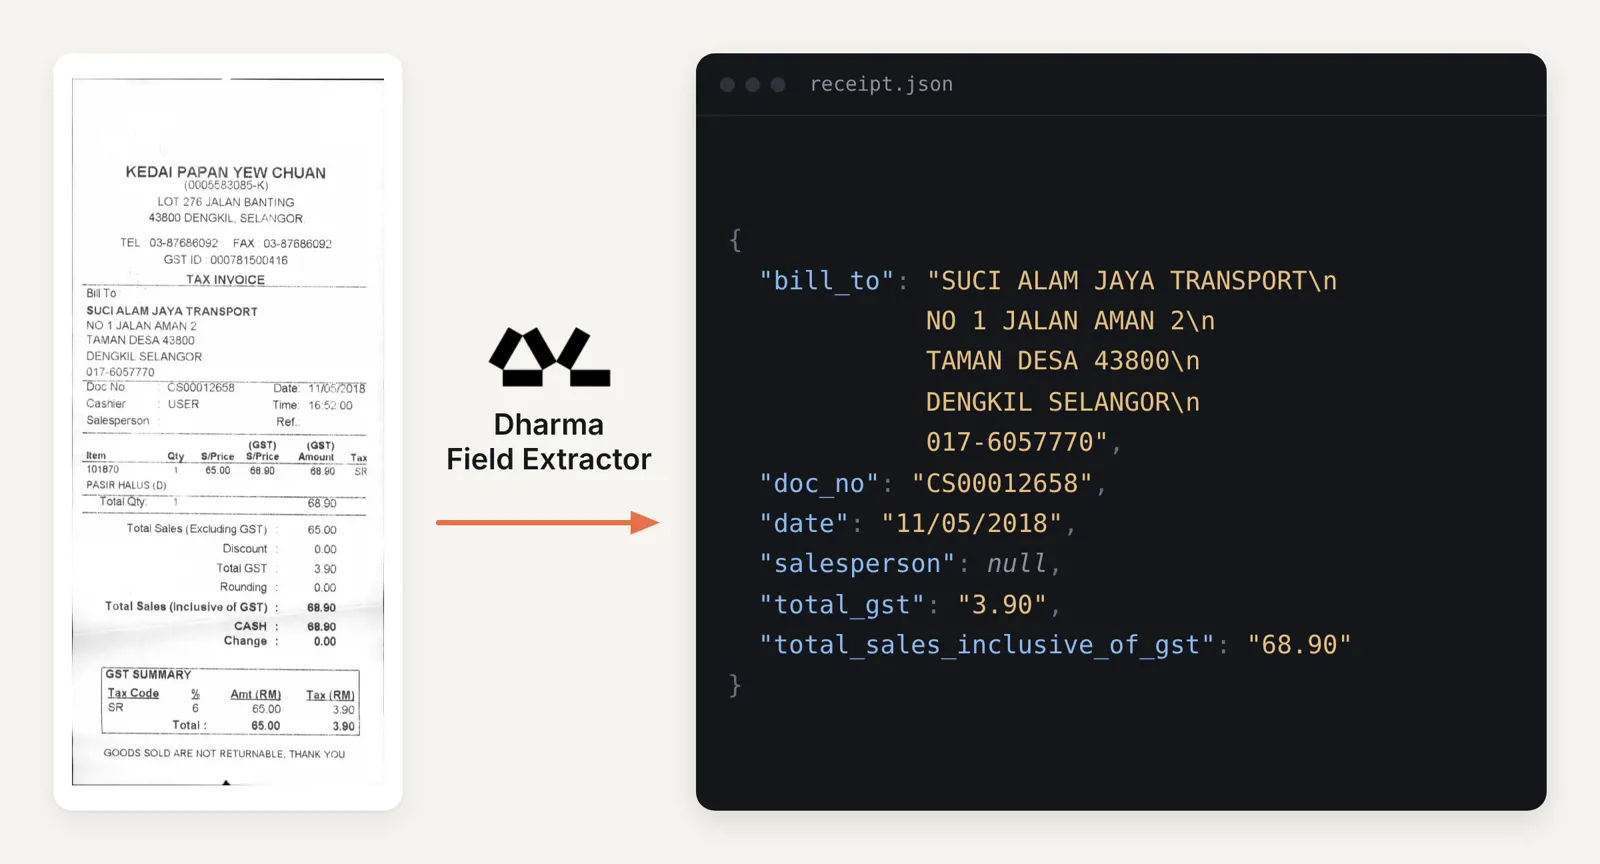
در یک نمونه رسید از SROIE، از مدل خواسته شد تا تمام ۱۸ فیلد چاپشده را استخراج کند. مدل همه را به درستی بازگرداند: آدرس صورتحساب چندخطی و بدون برچسب بهعنوان یک فیلد واحد ثبت شد، دو فیلد خالی به درستی null برگشت داده شد و هر عدد روی رسید تا سنت دقیق مطابقت داشت.
در یک نمونه فرم FUNSD، که شامل یک چکلیست از دوازده فیلد بولین با یک گروه تودرتو از پنج گزینه فرعی است، مدل دقیقاً گزینهای که تیک خورده بود (کیفیت پایین اصل سند) را true و یازده گزینه دیگر را false علامتگذاری کرد. همچنین شناسه دستنویس Bates را به درستی خواند و برای دو فیلد خالی null برگرداند.
نتیجهگیری: تخصص بر مقیاس غلبه میکند
مدلی با ۲ میلیارد پارامتر در این آزمون امتیاز ۰.۸۳۴ را کسب کرد که از تمام پیکربندیهای مدل عمومی مرزی که تست شد بالاتر بود، در حالی که روی یک L40S با هزینهای بهمراتب کمتر اجرا میشود. کیفیت بالاتر و هزینه پایینتر، هر دو در یک بنچمارک واحد اندازهگیری شدند.
این یافته از تز اصلی Dharma-AI پشتیبانی میکند: در یک کار محدود و مشخص، یک مدل کوچک که نزدیک به آن کار آموزش دیده باشد، از یک مدل مرزی که بهصورت عمومی همان کار را انجام میدهد، پیشی میگیرد. تعداد پارامترها سقف توانایی را تعیین میکند، اما این آموزش است که مشخص میکند مدل چقدر از این پتانسیل را در کار شما محقق میکند. کسبوکار شما به بزرگترین مدل موجود نیاز ندارد، بلکه به مدلی نیاز دارد که برای مشکل شما آموزش دیده باشد.
پرسشهای متداول
Dharma Field Extractor چه کاری انجام میدهد؟
این مدل یک تصویر سند و یک درخواست (باز یا مبتنی بر اسکیما) دریافت میکند و دادههای ساختاریافته بهصورت JSON برمیگرداند. میتواند تمام فیلدهای قابل شناسایی را استخراج کند یا دقیقاً فیلدهای مشخصشده در اسکیما را پر کند.
آیا این مدل فقط برای اسناد انگلیسی کار میکند؟
خیر. مدل روی ترکیبی از دادههای انگلیسی چنددامنه، اسناد واقعی برزیلی (پرتغالی) و دادههای چندزبانه دیگر آموزش دیده تا فراتر از انگلیسی و پرتغالی تعمیم یابد.
کارایی و هزینه این مدل در مقایسه با مدلهای عمومی چگونه است؟
در یک بنچمارک اختصاصی، این مدل امتیاز ۰.۸۳۴ را کسب کرد که از تمام پیکربندیهای مدلهای عمومی مرزی مانند Claude Opus 5 (۰.۸۱۶) و GPT-5.6 Luna (۰.۷۴۱) بالاتر بود. همچنین هزینه اجرای خودمیزبانی آن روی یک GPU L40S، ۶ تا ۱۴۷ برابر کمتر از استفاده از APIهای تجاری برآورد شده است.
منبع: Hugging Face